import textwrap

import pandas as pd
import requests
from bs4 import BeautifulSoup
from lets_plot import *

LetsPlot.setup_html()Web scraping y API
Introducción
Este capítulo te mostrará cómo trabajar con datos en línea, ya sea obtenidos de páginas web mediante web scraping o de forma más directa a través de internet mediante una API. Un principio importante es usar siempre una API si hay una disponible, ya que está diseñada para pasar la información directamente a tu sesión de Python y te ahorrará mucho esfuerzo.
Consideraciones éticas y legales
Como ya dijimos, deberías usar una API siempre que puedas. Pero, para los casos en que no sea posible, ¿cuáles son las reglas del juego en lo que respecta al web scraping? Primero, tenemos que hablar de si es legal y ético hacerlo. En general, la situación es complicada en ambos aspectos.
Las cuestiones legales dependen mucho de dónde vivas. Sin embargo, como principio general, si los datos son públicos, no personales, no comerciales y fácticos, probablemente no tendrás problemas. Estos tres factores son importantes porque están relacionados con los términos y condiciones del sitio, la información de identificación personal y los derechos de autor, como veremos a continuación.
Si los datos no son públicos, no son no personales o no son fácticos, o si haces scraping de los datos específicamente para ganar dinero con ellos, o si haces scraping de algo que solo está disponible comercialmente, tendrás que hablar con un abogado. En cualquier caso, debes ser respetuoso con los recursos del servidor que aloja las páginas de las que haces scraping. Sobre todo, esto significa que, si haces scraping de muchas páginas, debes asegurarte de esperar un poco entre cada solicitud. Tenacity es un paquete excelente para esto: tiene una función que hace pausas entre intentos de hacer algo (además de muchas otras funcionalidades útiles).
Si te fijas bien, verás que muchos sitios web incluyen en algún lugar de la página un enlace a “términos y condiciones” o “términos de servicio”, y si lees esa página con atención a menudo descubrirás que el sitio prohíbe específicamente el web scraping. Estas páginas suelen ser un acaparamiento legal en el que las empresas hacen afirmaciones muy amplias. Es de buena educación respetar estos términos de servicio cuando sea posible, pero toma cualquier afirmación con cautela.
Los tribunales de EE. UU. han determinado en general que simplemente poner los términos de servicio en el pie de página del sitio web no basta para que quedes obligado por ellos, p. ej., HiQ Labs v. LinkedIn. Por lo general, para quedar obligado por los términos de servicio, debes haber realizado alguna acción explícita, como crear una cuenta o marcar una casilla. Por eso es importante si los datos son públicos o no; si no necesitas una cuenta para acceder a ellos, es poco probable que estés obligado por los términos de servicio. Ten en cuenta, sin embargo, que la situación es bastante distinta en Europa, donde los tribunales han determinado que los términos de servicio son exigibles incluso si no los aceptas explícitamente.
Incluso si los datos son públicos, debes tener muchísimo cuidado al hacer scraping de información de identificación personal, como nombres, direcciones de correo electrónico, números de teléfono, fechas de nacimiento, etc. Europa tiene leyes estrictas sobre la recopilación o el almacenamiento de este tipo de datos (conocidas como RGPD o GDPR), y, vivas donde vivas, probablemente te estarás metiendo en un atolladero ético. Por ejemplo, en 2016, un grupo de investigadores hizo scraping de la información de perfiles públicos (p. ej., nombres de usuario, edad, género, ubicación, etc.) de 70.000 personas en el sitio de citas OkCupid y publicaron estos datos sin ningún intento de anonimización. Aunque los investigadores consideraron que no había nada malo en ello, ya que los datos ya eran públicos, este trabajo fue ampliamente condenado por preocupaciones éticas sobre la identificabilidad de los usuarios cuya información se publicó en el dataset. Si tu trabajo implica hacer scraping de información de identificación personal, te recomendamos encarecidamente leer sobre el estudio de OkCupid3, así como sobre estudios similares con una ética de investigación cuestionable que implicaron la obtención y publicación de información de identificación personal.
Por último, también tienes que preocuparte por la ley de derechos de autor. La ley de derechos de autor es complicada. La ley de EE. UU. describe exactamente qué está protegido: “[…] obras originales de autoría fijadas en cualquier medio tangible de expresión, […]”. Luego describe categorías específicas a las que se aplica, como obras literarias, obras musicales, películas y más. Llama la atención que los datos no gozan de protección de derechos de autor. Esto significa que, mientras limites tu scraping a hechos, la protección de derechos de autor no se aplica. (Pero ten en cuenta que Europa tiene un derecho “sui generis” aparte que protege las bases de datos).
Como breve ejemplo, en EE. UU., las listas de ingredientes y las instrucciones no son protegibles por derechos de autor, así que los derechos de autor no pueden usarse para proteger una receta. Pero si esa lista de recetas va acompañada de un contenido literario original sustancial, eso sí es protegible. Por eso, cuando buscas una receta en internet, siempre hay tanto contenido antes.
Si necesitas hacer scraping de contenido original (como texto o imágenes), es posible que aun así estés protegido por la doctrina del uso legítimo (fair use). El uso legítimo no es una regla estricta, sino que sopesa varios factores. Es más probable que se aplique si recopilas los datos con fines de investigación o no comerciales y si limitas lo que extraes a solo lo que necesitas.
Requisitos previos
Para este capítulo necesitarás instalar el paquete pandas. También usaremos seaborn, que ya deberías tener instalado. Además, necesitarás instalar los paquetes beautifulsoup, pandas-datareader y wbgapi en tu terminal usando uv add beautifulsoup4, uv add pandas-datareader y uv add wbgapi, respectivamente. También usaremos dos paquetes integrados, textwrap y requests.
Para empezar, importemos algunos de los paquetes que necesitamos (siempre es una buena práctica importar los paquetes que necesitas al principio de un script o notebook).
Extraer datos de archivos en internet con pandas
Es fácil leer datos de internet una vez que tienes la URL y el tipo de archivo. Aquí, por ejemplo, hay un ejemplo que lee el dataset ‘storms’, que está almacenado como archivo CSV en una URL (solo tomaremos las primeras 10 filas):
pd.read_csv(
    "https://vincentarelbundock.github.io/Rdatasets/csv/dplyr/storms.csv", nrows=10
)| rownames | name | year | month | day | hour | lat | long | status | category | wind | pressure | tropicalstorm_force_diameter | hurricane_force_diameter | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | Amy | 1975 | 6 | 27 | 0 | 27.5 | -79.0 | tropical depression | NaN | 25 | 1013 | NaN | NaN |
| 1 | 2 | Amy | 1975 | 6 | 27 | 6 | 28.5 | -79.0 | tropical depression | NaN | 25 | 1013 | NaN | NaN |
| 2 | 3 | Amy | 1975 | 6 | 27 | 12 | 29.5 | -79.0 | tropical depression | NaN | 25 | 1013 | NaN | NaN |
| 3 | 4 | Amy | 1975 | 6 | 27 | 18 | 30.5 | -79.0 | tropical depression | NaN | 25 | 1013 | NaN | NaN |
| 4 | 5 | Amy | 1975 | 6 | 28 | 0 | 31.5 | -78.8 | tropical depression | NaN | 25 | 1012 | NaN | NaN |
| 5 | 6 | Amy | 1975 | 6 | 28 | 6 | 32.4 | -78.7 | tropical depression | NaN | 25 | 1012 | NaN | NaN |
| 6 | 7 | Amy | 1975 | 6 | 28 | 12 | 33.3 | -78.0 | tropical depression | NaN | 25 | 1011 | NaN | NaN |
| 7 | 8 | Amy | 1975 | 6 | 28 | 18 | 34.0 | -77.0 | tropical depression | NaN | 30 | 1006 | NaN | NaN |
| 8 | 9 | Amy | 1975 | 6 | 29 | 0 | 34.4 | -75.8 | tropical storm | NaN | 35 | 1004 | NaN | NaN |
| 9 | 10 | Amy | 1975 | 6 | 29 | 6 | 34.0 | -74.8 | tropical storm | NaN | 40 | 1002 | NaN | NaN |
Obtener datos mediante API
Usar una API (interfaz de programación de aplicaciones) es otra forma de obtener información de internet. Las API son simplemente una manera de que una herramienta, digamos Python, hable con otra herramienta, digamos un servidor, e intercambien información de forma útil. El caso de uso clásico sería enviar, mediante una API, una solicitud de datos que cumplan una determinada consulta y recibir a cambio una descarga de esos datos. (Siempre deberías usar preferentemente una API antes que hacer web scraping de un sitio).
Como están diseñadas para funcionar con cualquier herramienta, en realidad no necesitas un lenguaje de programación para interactuar con una API; simplemente es mucho más fácil si lo usas.
Nota
Para acceder a algunas API se necesita una clave de API (API key). A veces basta con registrarte en el sitio; en otros casos, puede que tengas que pagar por el acceso.
Para comprobarlo, usemos directamente una API para obtener algunos datos de series temporales. Haremos la llamada a internet con el paquete requests.
Una API tiene un ‘endpoint’, la URL base, y luego una URL que codifica la pregunta. Veamos un ejemplo con la API de la ONS, cuyo endpoint es “https://api.beta.ons.gov.uk/v1/”. El resto de la API tiene la forma ‘data?uri=’ seguida del ID largo tanto de la serie temporal (jp9z) como del dataset (LMS), que corresponde a las vacantes en el sector servicios del Reino Unido.
Los datos que devuelven las API suelen estar en formato JSON, que se parece mucho a un diccionario anidado de Python y a cuyas entradas se puede acceder de la misma manera; eso es lo que ocurre al obtener el título de la serie en el ejemplo siguiente. JSON no es bueno para el análisis, así que usaremos pandas para darles forma a los datos.
url = "https://api.beta.ons.gov.uk/v1/data?uri=/employmentandlabourmarket/peopleinwork/employmentandemployeetypes/timeseries/jp9z/lms/previous/v108"

# Get the data from the ONS API:
json_data = requests.get(url).json()

# Prep the data for a quick plot
title = json_data["description"]["title"]
df = (
    pd.DataFrame(pd.json_normalize(json_data["months"]))
    .assign(
        date=lambda x: pd.to_datetime(x["date"]),
        value=lambda x: pd.to_numeric(x["value"]),
    )
    .set_index("date")
)

df["value"].plot(title=title, ylim=(0, df["value"].max() * 1.2), lw=3.0);
/var/folders/8n/n8x6tb9n5tz72hhnwdf7l04w0000gn/T/ipykernel_75858/1249132001.py:11: UserWarning: Could not infer format, so each element will be parsed individually, falling back to `dateutil`. To ensure parsing is consistent and as-expected, please specify a format.
date=lambda x: pd.to_datetime(x["date"]),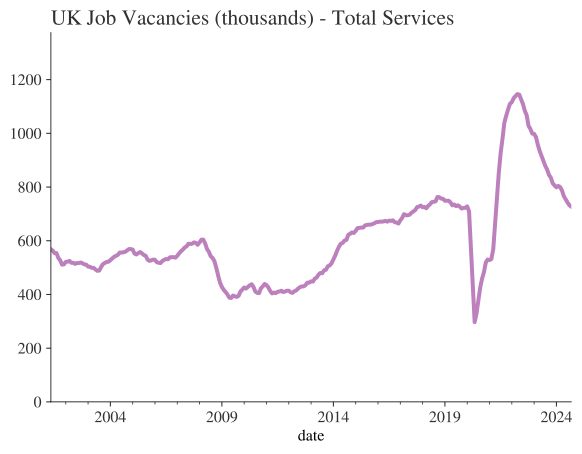
Hemos hablado de leer API. ¡También puedes crear la tuya propia para servir datos, modelos o lo que quieras! Es un tema avanzado y no lo cubriremos; pero si lo necesitas, la forma más sencilla es usar Fast API. Puedes encontrar algunos tutoriales breves en video sobre Fast API aquí.
Pandas Datareader: una forma más fácil de interactuar con (algunas) API
Aunque no hizo falta mucho código para obtener los datos de la ONS, sería aún mejor si fuera una sola línea, ¿verdad? Por suerte, existen algunos paquetes que lo facilitan, aunque depende de la API (y las API aparecen y desaparecen con el tiempo).
Con diferencia, la librería más completa para acceder a otras API es pandas-datareader, que ofrece un acceso cómodo a:
- FRED
- Quandl
- World Bank
- OECD
- Eurostat
y más.
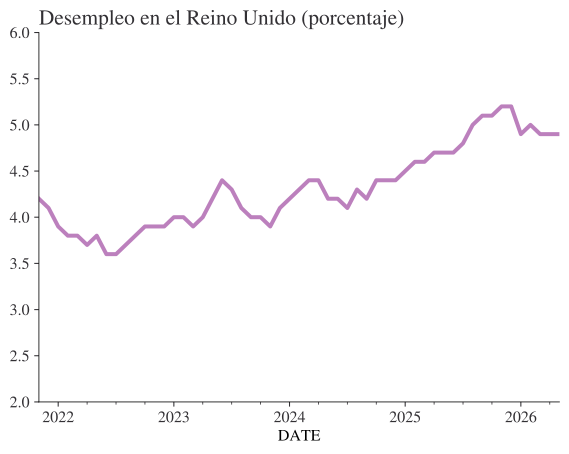
Veamos un ejemplo con FRED (la librería de datos económicos del Banco de la Reserva Federal de St. Louis). Esta vez, veamos la tasa de desempleo del Reino Unido:
import pandas_datareader.data as web

df_u = web.DataReader("LRHUTTTTGBM156S", "fred")

df_u.plot(
    title="Desempleo en el Reino Unido (porcentaje)", legend=False, ylim=(2, 6), lw=3.0
);
Y, como también es muy útil, veamos cómo usar el paquete wbgapi para acceder a datos del Banco Mundial. (pandas-datareader también solía ofrecer un lector para el Banco Mundial, pero no se ha mantenido activamente, así que preferimos wbgapi para trabajos nuevos).
# World Bank CO2 equivalent emissions (metric tons per capita)
# https://data.worldbank.org/indicator/EN.GHG.ALL.PC.CE.AR5
# country and region codes at http://api.worldbank.org/v2/country
import wbgapi as wb

indicator_code = "EN.GHG.ALL.PC.CE.AR5"
df = (
    wb.data.DataFrame(
        indicator_code,
        ["USA", "CHN", "IND", "EAS", "ECS"],  # country and region codes
        time=range(2019, 2020),
        labels=True,
    )
    .rename(columns={"Country": "country", "YR2019": indicator_code})
    .reset_index(drop=True)
)
df["country"] = df["country"].apply(lambda x: textwrap.fill(x, 10))  # wrap long names
df = df.sort_values(indicator_code)  # re-order
df.head()| country | EN.GHG.ALL.PC.CE.AR5 | |
|---|---|---|
| 2 | India | 2.621464 |
| 1 | East Asia\n& Pacific | 8.435052 |
| 0 | Europe &\nCentral\nAsia | 9.171476 |
| 3 | China | 9.982534 |
| 4 | United\nStates | 18.921098 |
(
    ggplot(df, aes(x="country", y=indicator_code))
    + geom_bar(aes(fill="country"), color="black", alpha=0.8, stat="identity")
    + scale_fill_discrete()
    + theme_minimal()
    + theme(legend_position="none")
    + ggsize(600, 400)
    + labs(
        subtitle="Gases de efecto invernadero (toneladas métricas de CO2 equivalente per cápita, 2019)",
        title="EE. UU. lidera el mundo en emisiones per cápita",
        y="",
    )
)
La API de la OCDE
A veces conviene usar las API directamente y, por ejemplo, la API de la OCDE trae MUCHA complejidad que el acceso directo puede aprovechar. La API de la OCDE ofrece los datos en formato JSON y XML, y usaremos pandasdmx (también conocido como el paquete Statistical Data and Metadata eXchange (SDMX) para el ecosistema de datos de Python) para descargar los datos en formato XML y convertirlos en un dataframe normal de pandas.
La clave para usar la API de la OCDE es conocer sus numerosos códigos: para países, periodos, recursos y series. Puedes encontrar una orientación general sobre los códigos que usa la API aquí, pero dar exactamente con lo que necesitas puede ser algo complicado. Dos consejos: 1. Si sabes que lo que buscas está en un dataset con un nombre concreto, p. ej., “QNA” (Quarterly National Accounts), pon https://stats.oecd.org/restsdmx/sdmx.ashx/GetDataStructure/QNA/all?format=SDMX-ML en tu navegador y revisa el archivo XML; ahí puedes identificar los subcódigos y los países disponibles. 2. Navega por https://stats.oecd.org/ y usa Customise; luego marca todas las casillas “Use Codes” para ver los nombres de código de lo que estés consultando.
Veamos un ejemplo en acción. Queremos ver los datos de productividad (PIB por hora) de varios países desde 2010. Usaremos el recurso de productividad (código “PDB_LV”) y queremos la medida a precios corrientes en USD (código “CPC”) del PIB por trabajador ocupado (código “T_GDPEMP) desde 2010 en adelante (código”startTime=2010”). Obtendremos esto para algunos países desarrollados donde las mediciones de productividad pueden ser algo más comparables. Los comentarios de abajo explican qué ocurre en cada paso.
import pandasdmx as pdmx
# Tell pdmx we want OECD data
oecd = pdmx.Request("OECD")
# Set out everything about the request in the format specified by the OECD API
data = oecd.data(
    resource_id="PDB_LV",
    key="GBR+FRA+CAN+ITA+DEU+JPN+USA.T_GDPEMP.CPC/all?startTime=2010",
).to_pandas()

df = pd.DataFrame(data).reset_index()
df.head()| LOCATION | SUBJECT | MEASURE | TIME_PERIOD | value | |
|---|---|---|---|---|---|
| 0 | CAN | T_GDPEMP | CPC | 2010 | 78848.604088 |
| 1 | CAN | T_GDPEMP | CPC | 2011 | 81422.364748 |
| 2 | CAN | T_GDPEMP | CPC | 2012 | 82663.028058 |
| 3 | CAN | T_GDPEMP | CPC | 2013 | 86368.582158 |
| 4 | CAN | T_GDPEMP | CPC | 2014 | 89617.632446 |
¡Genial, funcionó! Tenemos los datos en un formato tidy muy cómodo.
Otras API útiles
- Hay una lista de API que se actualiza con regularidad en este repositorio de API públicas en github. No tiene (todavía) una sección de economía, pero tiene MUCHAS otras API.
- La Berkeley Library mantiene una lista de API de economía que vale mucho la pena revisar.
- NASDAQ Data Link, que tiene una gran cantidad de datos financieros.
- DBnomics: datos económicos públicos proporcionados por instituciones estadísticas nacionales e internacionales, pero también por investigadores y empresas privadas.
Web scraping
El web scraping es una forma de obtener de internet información pensada para mostrarse en un navegador. Pero solo debería usarse como último recurso, y únicamente cuando lo permitan los términos y condiciones del sitio web.
Si vas a obtener datos de internet, es mucho mejor usar una API siempre que puedas: obtener información de forma estructurada es exactamente la razón de ser de las API. Además, las API deberían ser más estables que los sitios web, que pueden cambiar con frecuencia. Normalmente, si una organización está de acuerdo en que obtengas sus datos, habrá creado una API expresamente para ello. Es bastante raro que exista un sitio web importante que sí permita el web scraping pero no tenga una API; en esos sitios, si no tienen API, lo más probable es que el scraping vaya en contra de sus términos y condiciones. Esos términos y condiciones pueden ser exigibles legalmente (las normas varían según el país, y de verdad necesitas asesoría legal si no está claro si puedes hacer scraping o no).
Hay otras razones por las que el web scraping no es tan buena idea; por ejemplo, si necesitas datos históricos, puede que estén disponibles a través de una API pero no se muestren en la página web. (O puede que no estén disponibles en absoluto, en cuyo caso lo mejor es contactar con la organización o consultar la WaybackMachine por si tomó capturas).
Así que este libro es bastante crítico con el web scraping, ya que casi siempre hay una solución mejor. Sin embargo, hay ocasiones en que resulta útil.
Si te encuentras en una situación en la que necesitas hacer scraping, asegúrate muy bien de que está permitido legalmente y también de que no infringes las reglas del robots.txt del sitio web: es un archivo especial presente en casi todos los sitios web que establece qué se puede rastrear legítimamente (siempre que sea legal) y en qué no deberían meterse los robots.
En Python tienes mucho donde elegir en cuanto a web scraping. Hay cinco librerías muy sólidas que cubren una amplia gama de estilos y necesidades: requests, lxml, beautifulsoup, selenium y *scrapy**.
Para un web scraping rápido y sencillo, mi combinación habitual sería requests, que se limita prácticamente a obtener el HTML de una página web, y beautifulsoup, que te ayuda a navegar por la estructura de la página y extraer lo que realmente te interesa. Para páginas web dinámicas que usan javascript en lugar de solo HTML, necesitarás selenium. Para escalar y acceder a miles de páginas web de forma eficiente, puedes probar scrapy, que puede funcionar junto con las otras herramientas y gestionar múltiples sesiones, además de todo tipo de extras… de hecho, es un “framework de web scraping”.
Siempre ayuda ver el código en la práctica, así que eso haremos ahora, pero ten en cuenta que omitiremos muchos detalles importantes, como los user agents, ser “educado” con tus peticiones de scraping o ser eficiente con la caché y el rastreo.
A falta de un ejemplo mejor, hagamos scraping de la página de investigación de http://aeturrell.com/
url = "http://aeturrell.com/research"
page = requests.get(url)
page.text[:300]
'<!DOCTYPE html>\n<html xmlns="http://www.w3.org/1999/xhtml" lang="en" xml:lang="en"><head>\n\n<meta charset="utf-8">\n<meta name="generator" content="quarto-1.9.32">\n\n<meta name="viewport" content="width=device-width, initial-scale=1.0, user-scalable=yes">\n\n<meta name="author" content="Arthur Turrell">\n'Bien, ¿qué acaba de pasar? Le pedimos a requests que obtuviera el HTML de la página web y luego imprimimos los primeros 300 caracteres del texto que encontró.
Ahora vamos a convertir esto en algo que los humanos puedan leer (o leer con más facilidad) usando beautifulsoup:
soup = BeautifulSoup(page.text, "html.parser")
print(soup.prettify()[60000:60500])
stem, Part IV
</i>
. Sante Fe Institute, 2025. doi:
<a href="https://doi.org/10.37911/9781947864665.11">
<code>
https://doi.org/10.37911/9781947864665.11
</code>
</a>
</p>
</div>
<div class="thumbnail">
<img alt="Travel time from St. Helens, UK" src="../research/chapters/turrell-2025/travel_area_web.webp"/>
</div>
<div class="project-categories">
<divAhora vemos más estructura de la página e incluso algunas etiquetas HTML, como ‘title’ y ‘link’. Llegamos a la parte de extracción de datos: supongamos que queremos extraer cada párrafo de texto; podemos usar beautifulsoup para recorrer la estructura HTML y extraer solo las partes con la etiqueta de párrafo (‘p’).
# Get all paragraphs
all_paras = soup.find_all("p")
# Just show one of the paras
all_paras[1]
<p>Blundell, Jack, Emma Duchini, Stefania Simion, and Arthur Turrell. "Pay transparency and gender equality." <i>American Economic Journal: Economic Policy</i> (2024). doi: <a href="https://www.aeaweb.org/articles?id=10.1257/pol.20220766&from=f"><code>10.1257/pol.20220766</code></a></p>Aunque este párrafo no está tan mal, puedes hacerlo más legible eliminando por completo las etiquetas HTML con el método .text:
all_paras[1].text'Blundell, Jack, Emma Duchini, Stefania Simion, and Arthur Turrell. "Pay transparency and gender equality." American Economic Journal: Economic Policy (2024). doi: 10.1257/pol.20220766'Ahora supongamos que no nos interesa la mayor parte de la página y solo queremos obtener los nombres de los proyectos. Para ello necesitamos identificar el tipo de etiqueta del elemento que nos interesa, en este caso ‘div’, y su clase, en este caso “project-name”. Lo hacemos así (y de paso mostramos el texto limpio):
projects = soup.find_all("div", class_="project-content listing-pub-info")
projects = [x.text.strip() for x in projects]
projects
['Blundell, Jack, Emma Duchini, Stefania Simion, and Arthur Turrell. "Pay transparency and gender equality." American Economic Journal: Economic Policy (2024). doi: 10.1257/pol.20220766',
'Botta, Federico, Robin Lovelace, Laura Gilbert, and Arthur Turrell. "Packaging code and data for reproducible research: A case study of journey time statistics." Environment and Planning B: Urban Analytics and City Science (2024): 23998083241267331. doi: 10.1177/23998083241267331',
'Kalamara, Eleni, Arthur Turrell, Chris Redl, George Kapetanios, and Sujit Kapadia. "Making text count: economic forecasting using newspaper text." Journal of Applied Econometrics 37, no. 5 (2022): 896-919. doi: 10.1002/jae.2907',
'Turrell, A., Speigner, B., Copple, D., Djumalieva, J. and Thurgood, J., 2021. Is the UK’s productivity puzzle mostly driven by occupational mismatch? An analysis using big data on job vacancies. Labour Economics, 71, p.102013. doi: 10.1016/j.labeco.2021.102013',
'Haldane, Andrew G., and Arthur E. Turrell. "Drawing on different disciplines: macroeconomic agent-based models." Journal of Evolutionary Economics 29 (2019): 39-66. doi: 10.1007/s00191-018-0557-5',
'Haldane, Andrew G., and Arthur E. Turrell. "An interdisciplinary model for macroeconomics." Oxford Review of Economic Policy 34, no. 1-2 (2018): 219-251. doi: 10.1093/oxrep/grx051',
'Braun-Munzinger, Karen, Z. Liu, and A. E. Turrell. "An agent-based model of corporate bond trading." Quantitative Finance 18, no. 4 (2018): 591-608. doi: 10.1080/14697688.2017.1380310',
'Turrell, A. E., M. Sherlock, and S. J. Rose. "Efficient evaluation of collisional energy transfer terms for plasma particle simulations." Journal of Plasma Physics 82, no. 1 (2016): 905820107. doi: 10.1017/S0022377816000131',
'Turrell, A. E., M. Sherlock, and S. J. Rose. "Ultrafast collisional ion heating by electrostatic shocks." Nature Communications 6, no. 1 (2015): 8905. doi: 10.1038/ncomms9905',
'Turrell, Arthur E., Mark Sherlock, and Steven J. Rose. "Self-consistent inclusion of classical large-angle Coulomb collisions in plasma Monte Carlo simulations." Journal of Computational Physics 299 (2015): 144-155. doi: 10.1016/j.jcp.2015.06.034',
'Turrell, Arthur E., Mark Sherlock, and Steven J. Rose. "A Monte Carlo algorithm for degenerate plasmas." Journal of Computational Physics 249 (2013): 13-21. doi: 10.1016/j.jcp.2013.03.052',
'Turrell, Arthur. "Cutting through Complexity: How Data Science Can Help Policymakers Understand the World." In The Economy as a Complex Evolving System, Part IV. Sante Fe Institute, 2025. doi: https://doi.org/10.37911/9781947864665.11',
'Duchini, Emma, Stefania Simion, and Arthur Turrell. "A Review of the Effects of Pay Transparency." In Oxford Research Encyclopedia of Economics and Finance, Oxford University Press, 2024. doi: 10.1093/acrefore/9780190625979.013.860',
'Turrell, Arthur, Bradley Speigner, Jyldyz Djumalieva, David Copple, and James Thurgood. "6. Transforming Naturally Occurring Text Data into Economic Statistics." In Big Data for Twenty-First-Century Economic Statistics, pp. 173-208. University of Chicago Press, 2022. doi: 10.7208/chicago/9780226801391-008',
'Turrell, Arthur. "Agent-based models: understanding the economy from the bottom up" In Quarterly Bulletin, Q4. Bank of England, 2016.',
'Codreanu, Mihai, Alex Imas, Juan Mateos-Garcia, Joseph Emmens, Evalyne Muiruri, Arthur Turrell, Julian Jacobs, Atoosa Kasirzadeh, Ana Trisovic, Yiyuan Chen, Tanya Rodchenko, Catherine Pollard, Scott Strand, Daniel Rock, Zanna Iscenko, Fabien Curto Millet, Neil Thompson, and James Manyika. AI in Science: Early Insights arXiv preprint arXiv:2609.28504v2 (2026).',
'Cohen, Samuel N., Giulia Mantoan, Lars Nesheim, Áureo de Paula, Arthur Turrell, and Lingyi Yang. Nowcasting using regression on signatures arXiv preprint arXiv:2305.10256v3 (2026).',
'Van Dijcke, David, Marcus Buckmann, Arthur Turrell, and Tomas Key. "Vacancy Posting, Firm Balance Sheets, and Pandemic Policy Interventions." Bank of England Staff Working Paper Series 1033 (2022).',
'Draca, Mirko, Emma Duchini, Roland Rathelot, Arthur Turrell, and Giulia Vattuone. Revolution in Progress? The Rise of Remote Work in the UK. University of Warwick, Department of Economics, 2022.',
'Hill, Edward, Marco Bardoscia, and Arthur Turrell. "Solving heterogeneous general equilibrium economic models with deep reinforcement learning." arXiv arXiv:2103.16977 (2021).',
'Turrell, Arthur, James Thurgood, David Copple, Jyldyz Djumalieva, and Bradley Speigner. "Using online job vacancies to understand the UK labour market from the bottom-up." Bank of England Staff Working Papers 742 (2018).']¡Hurra! Conseguimos la información que queríamos: solo necesitábamos conocer las etiquetas correctas. Un buen consejo para encontrar las etiquetas de la información que buscas es abrir la página en tu navegador (p. ej., Google Chrome), hacer clic derecho sobre la parte que te interesa y pulsar ‘Inspeccionar’. Esto te mostrará el elemento HTML de la parte de la página en la que hiciste clic.
Eso es casi todo en esta brevísima introducción al web scraping. Solo veremos una cosa más: cómo iterar sobre varias páginas.
Imagina que tenemos una página web raíz como “www.codingforeconomists.com” con subpáginas como “www.codingforeconomists.com/page=1”, “www.codingforeconomists.com/page=2”, etc. Basta con generar iterativamente los strings HTML para pasarlos a una función que haga scraping de cada una y devuelva los datos relevantes; por ejemplo, para las primeras 50 páginas y con una función llamada scraper(), podrías ejecutar
start, stop = 0, 50
root_url = "www.codingforeconomists.com/page="
info_on_pages = [scraper(root_url + str(i)) for i in range(start, stop)]
Eso es todo lo que veremos aquí, pero recuerda que apenas hemos rascado la superficie de este tema amplio y complejo. Si quieres leer sobre una aplicación, es difícil no recomendar el artículo sobre web scraping que sin duda más ha cambiado el mundo, y que muy probablemente ha influido en tu propia vida de muchas maneras: “The PageRank Citation Ranking: Bringing Order to the Web” de Page, Brin, Motwani y Winograd. Para un ejemplo más detallado de web scraping, consulta el tutorial de realpython.
Web scraping de tablas
A menudo no quieres hacer scraping de una página web completa, sino que solo quieres los datos de una tabla dentro de la página. Por suerte, hay una forma sencilla de hacer scraping de tablas individuales con el paquete pandas.
Leeremos los datos de una tabla de ‘https://webscraper.io/test-sites/tables’ usando pandas. La función que usaremos es read_html(), que devuelve una lista de dataframes con todas las tablas que encuentra cuando le pasas una URL. Si quieres filtrar la lista de tablas, usa el argumento match= con un texto que solo aparezca en la(s) tabla(s) que te interesan.
El ejemplo siguiente muestra cómo funciona esto; si miramos el sitio web, vemos que la tabla que nos interesa tiene una columna ‘First Name’. Por lo tanto, ejecutamos:
df_list = pd.read_html("https://webscraper.io/test-sites/tables", match="First Name")
# Retrieve first entry from list of data frames
df = df_list[0]
df.head()| # | First Name | Last Name | Username | |
|---|---|---|---|---|
| 0 | 1 | Mark | Otto | @mdo |
| 1 | 2 | Jacob | Thornton | @fat |
| 2 | 3 | Larry | the Bird |
Esto nos deja la tabla cargada de forma ordenada en un dataframe de pandas, lista para seguir usándola.
Si obtienes un error ‘403’, significa que el sitio web ha bloqueado a pandas porque detecta que estás haciendo web scraping. Esto ocurre porque algunas personas hacen web scraping de forma irresponsable, o porque los sitios web ofrecen otras formas preferidas de obtener los datos, por ejemplo, descargándolos completos (piensa en Wikipedia) o mediante una API. (Aun así, si de verdad lo necesitas, a menudo puedes sortear el error 403.)