Primeros pasos
La ciencia de datos es una disciplina apasionante que te permite convertir datos en bruto en comprensión, perspectiva y conocimiento. El objetivo de “Python for Data Science” es ayudarte a aprender las herramientas y los flujos de trabajo más importantes de Python para hacer ciencia de datos. ¡Después de leer este libro, tendrás las herramientas para afrontar una gran variedad de retos de ciencia de datos!
Qué aprenderás
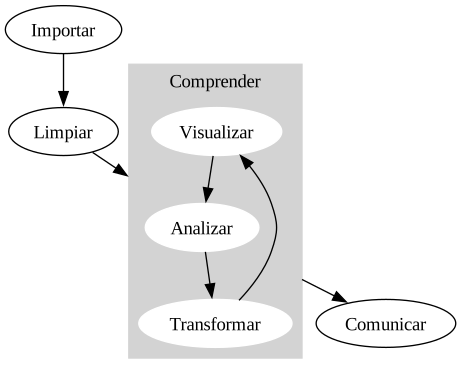
La ciencia de datos es un campo enorme, y es imposible dominarlo todo leyendo un solo libro. Este libro pretende darte una base sólida en las herramientas más importantes y conocimientos suficientes para encontrar los recursos con los que aprender más cuando lo necesites. Nuestro modelo de las herramientas necesarias en un proyecto típico de ciencia de datos se parece a esto:
Primero debes importar tus datos en Python. Normalmente, esto significa tomar datos almacenados en un archivo, una base de datos o una interfaz de programación de aplicaciones (API) web, y cargarlos en un ‘dataframe’ en Python. ¡No se puede hacer ciencia de datos sin datos!
Una vez que hayas importado tus datos, normalmente es necesario limpiarlos u ordenarlos. Limpiar los datos significa almacenarlos de forma consistente, de modo que la semántica del dataset coincida con la forma en que se almacena. ¡Es una manera elegante de decir que los datos están en un formato con el que puedes trabajar fácilmente! Los llamados datos “tidy” (ordenados) son un caso especial de datos tabulares estructurados en los que cada columna es una variable y cada fila es una observación (aunque no todos los datos son tabulares). Los datos limpios son importantes porque una estructura consistente te permite centrar tus esfuerzos en responder preguntas sobre los datos, en lugar de pelearte para darles la forma adecuada para distintas funciones.
Una vez que tienes datos limpios, un paso habitual es transformarlos. La transformación incluye acotar las observaciones de interés (como todas las personas de una ciudad o todos los datos del último año), crear nuevas variables que son funciones de variables existentes (como calcular la velocidad a partir de la distancia y el tiempo) y calcular un conjunto de estadísticas de resumen (como conteos o medias).
Una vez que tienes datos limpios con las variables que necesitas, hay dos motores principales de generación de conocimiento: la visualización y el análisis. Tienen fortalezas y debilidades complementarias, por lo que cualquier análisis real alternará entre ellos muchas veces.
La visualización es una actividad fundamentalmente humana. Una buena visualización te mostrará cosas que no esperabas o te planteará nuevas preguntas sobre los datos. Una buena visualización también puede sugerir que estás haciendo la pregunta equivocada o que necesitas recopilar datos diferentes. ¡Las visualizaciones pueden sorprenderte! Las hay de muchos tipos.
El análisis es un tema demasiado amplio para cubrirlo en este libro. Puede implicar ajustar modelos, hacer estadística, responder preguntas concretas o extraer un relato a partir de los datos. Es una habilidad importante, pero depende mucho del ámbito de aplicación.
El último paso de la ciencia de datos es la comunicación, una parte absolutamente crucial de cualquier proyecto de análisis de datos. Da igual lo bien que tus modelos y visualizaciones te hayan ayudado a comprender los datos si no eres capaz de comunicar tus resultados a otras personas.
Todas estas herramientas están rodeadas por la programación. La programación es una herramienta transversal que usas en casi todas las partes de un proyecto de ciencia de datos. No necesitas ser un programador experto para ser un buen científico de datos, pero aprender más sobre programación vale la pena, porque programar mejor te permite automatizar tareas comunes y resolver nuevos problemas con mayor facilidad.
Usarás estas herramientas en todos los proyectos de ciencia de datos pero, en la mayoría de ellos, no bastarán por sí solas. Se aplica aproximadamente una regla 80/20: puedes abordar cerca del 80 % de cada proyecto con las herramientas que aprenderás en este libro, pero necesitarás otras herramientas para el 20 % restante. A lo largo del libro te indicaremos recursos donde puedes aprender más.
Cómo está organizado este libro
La descripción anterior de las herramientas de la ciencia de datos está organizada aproximadamente según el orden en que las usas en un análisis (aunque, por supuesto, las recorrerás varias veces). Sin embargo, según nuestra experiencia, esta no es la mejor manera de aprenderlas. Esto se debe a que empezar con la ingesta y limpieza de datos suele ser o bien rutinario y aburrido, o bien extraño y frustrante, ¡y ambas cosas pueden desanimar cuando empiezas a aprender una materia nueva!
En su lugar, empezaremos con la visualización y la transformación de datos que ya se han importado y limpiado. Así, cuando ingieras y limpies tus propios datos, tu motivación se mantendrá alta porque sabrás que el esfuerzo merece la pena.
En cada capítulo intentamos seguir un patrón similar: empezar con algunos ejemplos motivadores para que veas el panorama general y luego entrar en los detalles. Cada sección del libro va acompañada de ejercicios para ayudarte a practicar lo aprendido. Aunque puede ser tentador saltarse los ejercicios, no hay mejor manera de aprender que practicar con problemas reales.
Qué no aprenderás
Hay varios temas importantes que este libro no cubre. Creemos que es importante centrarse sin concesiones en lo esencial para que puedas ponerte en marcha lo antes posible. Eso significa que este libro no puede cubrir todos los temas importantes.
Modelado
El modelado es increíblemente importante para la ciencia de datos, pero es un tema amplio y, por desgracia, aquí no tenemos espacio para tratarlo como se merece. Algunos buenos puntos de partida son los tutoriales de sklearn para machine learning, Causal inference for the brave and true y las páginas de Coding for Economists sobre regresión e inferencia bayesiana.
Big data
Este libro se centra en datasets pequeños, “en memoria” (más o menos, esto significa que puedes abrirlos en tu portátil). Es el punto de partida adecuado porque no puedes abordar big data sin tener experiencia con datos pequeños. Las herramientas que aprenderás en este libro manejan con facilidad cientos de megabytes de datos y, con un poco de cuidado, normalmente puedes usarlas para trabajar con 1-2 Gb (gigabytes) de datos. Si trabajas habitualmente con datos más grandes (digamos 10-100 Gb), deberías aprender más sobre bases de datos y herramientas como Ibis que te permiten interactuar con ellas.
(Si tus datos son más grandes que eso, considera detenidamente si tu problema de big data es en realidad un problema de datos pequeños disfrazado. Aunque el conjunto de datos completo sea grande, a menudo los datos necesarios para responder una pregunta concreta son pocos. Quizá puedas encontrar un subconjunto, una submuestra o un resumen que quepa en memoria y que aun así te permita responder la pregunta que te interesa. El reto aquí es encontrar los datos pequeños adecuados, lo que suele requerir mucha iteración.)
Otra posibilidad es que tu problema de big data sea en realidad un gran número de problemas de datos pequeños disfrazados. Cada problema individual podría caber en memoria, pero tienes millones de ellos. Por ejemplo, podrías querer ajustar un modelo para cada persona de tu dataset. Sería trivial si tuvieras solo 10 o 100 personas, pero en cambio tienes un millón. Por suerte, cada problema es independiente de los demás (una configuración que a veces se denomina vergonzosamente paralela), así que solo necesitas un sistema (como Hadoop o Spark) que te permita enviar distintos datasets a distintos ordenadores para procesarlos. Una vez que hayas averiguado cómo responder tu pregunta para un único subconjunto con las herramientas descritas en este libro, podrás aprender nuevas herramientas como pyspark para resolverla con el dataset completo.
Julia y R
En este libro no aprenderás nada sobre R ni Julia, que a veces también se usan para ciencia de datos. No es porque pensemos que sean malas herramientas. ¡No lo son! En este libro verás las que consideramos las tres herramientas fundamentales para la ciencia de datos:
- Python
- SQL
- scripting en la línea de comandos
Estos son los tres lenguajes que te permitirán conseguir trabajo como científico de datos, y esa es una muy buena razón para centrarse en ellos. Pasaremos la mayor parte del tiempo con Python, y con razón. Python suele clasificarse como el primer o segundo lenguaje de programación más popular del mundo y, algo igual de importante, también es uno de los más fáciles de aprender. Es un lenguaje de propósito general, lo que significa que puede realizar una amplia variedad de tareas. Esta combinación de características es la razón por la que se dice que Python tiene un suelo bajo y un techo alto. También es muy versátil; se suele bromear con que Python es el segundo mejor lenguaje en todo, y hay algo de verdad en ello (aunque Python es el mejor en algunas tareas, como machine learning). Pero un lenguaje que abarca tanto terreno también es muy útil; además, Python se usa ampliamente en la industria, el mundo académico y el sector público, y a menudo también se enseña en las escuelas.
Creemos que Python es un excelente punto de partida para tu recorrido en la ciencia de datos porque es la herramienta más popular para la ciencia de datos y, en general, para la programación, con una gran comunidad detrás.
Detalles sobre este libro
Este libro se compiló con la siguiente versión de Python:
Compiled with Python version: 3.12.14 (main, Sep 29 2026, 14:50:19) [Clang 22.1.3 ]Agradecimientos
Este libro es una reproducción muy cercana del libro R for Data Science (2e) y se inspiró en su esfuerzo por hacer la ciencia de datos más accesible en un libro fácil de asimilar.