import pandas as pd
from lets_plot import *

LetsPlot.setup_html()Capas
Introducción
En los capítulos anteriores aprendiste mucho más que a hacer scatter plots, gráficos de barras y boxplots. Aprendiste una base que puedes usar para hacer cualquier tipo de gráfico con lets-plot.
En este capítulo ampliarás esa base mientras aprendes sobre la gramática de gráficos por capas. Empezaremos profundizando en los mapeos estéticos, los objetos geométricos y las facetas. Luego, aprenderás sobre las transformaciones estadísticas que lets-plot realiza internamente al crear un gráfico. Estas transformaciones se usan para calcular nuevos valores que graficar, como las alturas de las barras en un gráfico de barras o las medianas en un boxplot. También aprenderás sobre los ajustes de posición, que modifican cómo se muestran los geoms en tus gráficos. Por último, presentaremos brevemente los sistemas de coordenadas.
No cubriremos cada función y opción de cada una de estas capas, pero te guiaremos por la funcionalidad más importante y de uso más frecuente que ofrece lets-plot.
Requisitos previos
Para este capítulo necesitarás instalar el paquete letsplot, además de pandas.
En tu sesión de Python, importa las librerías que usaremos:
Mapeos estéticos
“El mayor valor de una imagen es cuando nos obliga a notar lo que nunca esperábamos ver.” — John Tukey
En esta sección usaremos el dataset mpg, así que vamos a descargarlo.
mpg = pd.read_csv(
    "https://vincentarelbundock.github.io/Rdatasets/csv/ggplot2/mpg.csv", index_col=0
)

mpg = mpg.astype(
    {
        "manufacturer": "category",
        "model": "category",
        "displ": "double",
        "year": "int64",
        "cyl": "int64",
        "trans": "category",
        "drv": "category",
        "cty": "double",
        "hwy": "double",
        "fl": "category",
        "class": "category",
    }
)
mpg.head()| manufacturer | model | displ | year | cyl | trans | drv | cty | hwy | fl | class | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| rownames | |||||||||||
| 1 | audi | a4 | 1.8 | 1999 | 4 | auto(l5) | f | 18.0 | 29.0 | p | compact |
| 2 | audi | a4 | 1.8 | 1999 | 4 | manual(m5) | f | 21.0 | 29.0 | p | compact |
| 3 | audi | a4 | 2.0 | 2008 | 4 | manual(m6) | f | 20.0 | 31.0 | p | compact |
| 4 | audi | a4 | 2.0 | 2008 | 4 | auto(av) | f | 21.0 | 30.0 | p | compact |
| 5 | audi | a4 | 2.8 | 1999 | 6 | auto(l5) | f | 16.0 | 26.0 | p | compact |
Entre las variables de mpg están:
displ: el tamaño del motor de un auto, en litros. Una variable numérica.hwy: la eficiencia de combustible de un auto en carretera, en millas por galón (mpg). Un auto con baja eficiencia de combustible consume más combustible que uno con alta eficiencia cuando recorren la misma distancia. Una variable numérica.class: tipo de auto. Una variable categórica.
Empecemos visualizando la relación entre displ y hwy para varias clases (class) de autos. Podemos hacerlo con un scatter plot en el que las variables numéricas se mapean a las estéticas x e y, y la variable categórica se mapea a una estética como color o shape.
(ggplot(mpg, aes(x="displ", y="hwy", color="class")) + geom_point())(ggplot(mpg, aes(x="displ", y="hwy", shape="class")) + geom_point())De manera similar, también podemos mapear class a las estéticas size o alpha, que controlan la forma y la transparencia de los puntos, respectivamente.
(ggplot(mpg, aes(x="displ", y="hwy", size="class")) + geom_point())(ggplot(mpg, aes(x="displ", y="hwy", alpha="class")) + geom_point())Aunque podemos hacerlo, mapear una variable discreta no ordenada (categórica) (class) a una estética ordenada (size o alpha) en general no es buena idea, porque implica una jerarquía que en realidad no existe.
Una vez que mapeas una estética, lets-plot se encarga del resto. Selecciona una escala razonable para usar con la estética y construye una leyenda que explica el mapeo entre niveles y valores. Para las estéticas x e y, lets-plot no crea una leyenda, pero sí crea una línea de eje con marcas y una etiqueta. La línea del eje proporciona la misma información que una leyenda: explica el mapeo entre ubicaciones y valores.
También puedes fijar manualmente las propiedades visuales de tu geom como argumento de la función geom (fuera de aes()) en lugar de depender de un mapeo de variables para determinar su apariencia. Por ejemplo, podemos hacer que todos los puntos de nuestro gráfico sean azules:
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point(color="blue"))Aquí, el color no transmite información sobre una variable, sino que solo cambia la apariencia del gráfico. Tendrás que elegir un valor que tenga sentido para esa estética:
- El nombre de un color como string, p. ej.,
color = "blue" - El tamaño de un punto en mm, p. ej.,
size = 1 - La forma de un punto como número, p. ej.,
shape = 1.
Intenta modificar el gráfico anterior pero, en lugar de especificar el color, especifica la estética de forma. ¿Qué obtienes con shape igual a 1, 2 o 3?
Hasta ahora hemos hablado de las estéticas que podemos mapear o fijar en un scatter plot, al usar un geom de puntos.
Las estéticas específicas que puedes usar en un gráfico dependen del geom que uses para representar los datos. En la siguiente sección profundizamos en los geoms.
Crea un scatter plot de
hwyfrente adisplen el que los puntos sean triángulos rellenos de color rosa.¿Por qué el siguiente código no produce un gráfico con puntos azules?
(
    ggplot(mpg) +
  geom_point(aes(x = "displ", y = "hwy", color = "blue"))
)
¿Qué hace la estética
stroke? ¿Con qué formas funciona? (Pista: usastrokeen la estética global yshapeengeom_point())Intenta modificar el último gráfico de arriba pero, en lugar de especificar el color, especifica la estética de forma. ¿Qué obtienes con shape igual a 1, 2 o 3?
Objetos geométricos
¿En qué se parecen estos dos gráficos?
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point(size=4))(ggplot(mpg, aes(x="displ", y="hwy")) + geom_smooth(method="loess", size=2))Ambos gráficos contienen la misma variable x, la misma variable y, y ambos describen los mismos datos. Pero los gráficos no son idénticos. Cada gráfico usa un objeto geométrico distinto, o geom, para representar los datos. El gráfico de la izquierda usa el geom de puntos, y el de la derecha usa el geom smooth, una línea suavizada ajustada a los datos.
Para cambiar el geom de tu gráfico, cambia la función geom que añades a ggplot().
Cada función geom de lets-plot acepta un argumento mapping, definido localmente en la capa del geom o globalmente en la capa ggplot(). Sin embargo, no todas las estéticas funcionan con todos los geoms. Puedes fijar la forma de un punto, pero no podrías fijar la “forma” de una línea. Si lo intentas, lets-plot ignorará silenciosamente ese mapeo estético. En cambio, sí podrías fijar el tipo de línea (linetype). geom_smooth() dibujará una línea diferente, con un tipo de línea diferente, para cada valor único de la variable que mapees a linetype.
Veamos:
(ggplot(mpg, aes(x="displ", y="hwy", line="drv")) + geom_smooth(method="loess"))(ggplot(mpg, aes(x="displ", y="hwy", linetype="drv")) + geom_smooth(method="loess"))Aquí, geom_smooth() separa los autos en tres líneas según su valor de drv, que describe el tipo de tracción del auto. Una línea describe todos los puntos con valor 4, otra describe todos los puntos con valor f y otra describe todos los puntos con valor r. Aquí, 4 significa tracción en las cuatro ruedas, f tracción delantera y r tracción trasera.
Si esto resulta demasiado confuso, podemos aclararlo superponiendo las líneas sobre los datos sin procesar y luego coloreando todo según drv.
(
    ggplot(mpg, aes(x="displ", y="hwy", color="drv"))
    + geom_point()
    + geom_smooth(aes(linetype="drv"), method="loess")
)
Observa que este gráfico contiene dos geoms en la misma figura.
Muchos geoms, como geom_smooth(), usan un único objeto geométrico para mostrar varias filas de datos. Para estos geoms, puedes asignar la estética group a una variable categórica para dibujar varios objetos. lets-plot dibujará un objeto separado para cada valor único de la variable de agrupación. En la práctica, lets-plot agrupará automáticamente los datos de estos geoms siempre que mapees una estética a una variable discreta. Es conveniente aprovechar esta característica, porque la estética group por sí sola no añade una leyenda ni rasgos distintivos a los geoms.
Ten en cuenta que si colocas mapeos en una función geom, lets-plot los tratará como mapeos locales de esa capa. Usará estos mapeos para ampliar o sobrescribir los mapeos globales solo para esa capa. Esto permite mostrar estéticas diferentes en capas diferentes.
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point(aes(color="class")) + geom_smooth())Puedes usar la misma idea para especificar datos diferentes en cada capa. Aquí usamos puntos rojos y círculos abiertos para resaltar los autos biplaza. El argumento de datos local en geom_point() sobrescribe el argumento de datos global en ggplot() solo para esa capa.
(
    ggplot(mpg, aes(x="displ", y="hwy"))
    + geom_point()
    + geom_point(data=mpg.loc[mpg["class"] == "2seater", :], color="red", size=2)
    + geom_point(
        data=mpg.loc[mpg["class"] == "2seater", :], shape=1, size=3, color="red"
    )
)
Los geoms son los componentes fundamentales de lets-plot. Puedes transformar por completo el aspecto de tu gráfico cambiando su geom, y distintos geoms pueden revelar distintas características de tus datos.
lets-plot ofrece más de 40 geoms, pero no cubren todos los gráficos posibles. Puedes encontrar un resumen en la parte correspondiente de la documentación de lets-plot.
Si necesitas un geom que no está incluido, tienes tres opciones principales: 1. Buscar paquetes que extiendan lets-plot y que hagan lo que necesitas 2. Abrir un issue en la página de Github de lets-plot solicitándolo como nueva funcionalidad, aunque ten en cuenta que puede no ser una prioridad para los mantenedores y no hay garantía de que lo añadan, según lo útil que sea para otros y lo fácil que sea de implementar. 3. Recurrir a un paquete de gráficos imperativo que te dé un control detallado para construir tu propio gráfico desde cero; matplotlib es absolutamente excelente para esto.
Ejercicios
¿Qué geom usarías para dibujar un gráfico de líneas? ¿Un boxplot? ¿Un histograma? ¿Un gráfico de área?
¿Qué efecto tendría ejecutar el ejemplo anterior:
(
ggplot(mpg, aes(x = "displ", y = "hwy", alpha = "class")) +
  geom_point()
)
with the keyword argument
show_legend=Falsehave on the chart generated by this code?¿Qué hace el argumento
sedegeom_smooth()?Recrea el código Python necesario para generar el siguiente gráfico.
Facetas
En Visualización de datos aprendiste sobre las facetas con facet_wrap(), que divide un gráfico en subgráficos que muestran cada uno un subconjunto de los datos según una variable categórica.
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point() + facet_wrap("cyl"))Para dividir tu gráfico en facetas según la combinación de dos variables, cambia de facet_wrap() a facet_grid().
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point() + facet_grid("drv", "cyl"))De forma predeterminada, todas las facetas comparten la misma escala y el mismo rango en los ejes x e y. Esto resulta útil cuando quieres comparar datos entre facetas, y es la opción predeterminada recomendada, pero puede ser limitante cuando quieres visualizar mejor la relación dentro de cada faceta. Si estableces el argumento scales de una función de facetado en "free", permitirás escalas de ejes distintas tanto en filas como en columnas; "free_x" permitirá escalas distintas entre filas, y "free_y" permitirá escalas distintas entre columnas.
(
    ggplot(mpg, aes(x="displ", y="hwy"))
    + geom_point()
    + facet_grid("drv", "cyl", scales="free_y")
)
(ggplot(mpg) + geom_point(aes(x="displ", y="hwy")) + facet_wrap("class", nrow=2))Ejercicios
¿Qué ocurre si haces facetas sobre una variable continua?
¿Qué significan las celdas vacías del gráfico con
facet_grid("drv", "cyl")? Ejecuta el siguiente código. ¿Qué relación tienen con el gráfico resultante?( ggplot(mpg) + geom_point(aes(x = "drv", y = "cyl")) )¿Qué gráficos genera el siguiente código? ¿Qué efecto tiene omitir la segunda variable?
(
  ggplot(mpg) +
  geom_point(aes(x = "displ", y = "hwy")) +
  facet_grid("drv")
)

(
  ggplot(mpg) +
  geom_point(aes(x = displ, y = "hwy")) +
  facet_grid("cyl")
)
Toma el primer gráfico con facetas de esta sección:
(
    ggplot(mpg) +
      geom_point(aes(x = "displ", y = "hwy")) +
      facet_wrap("class", nrow = 2)
)
¿Qué ventajas tiene usar facetas en lugar de la estética de color? ¿Cuáles son las desventajas? ¿Cómo podría cambiar el equilibrio si tuvieras un dataset más grande?
Lee
help(facet_wrap)o pasa el ratón por encima defacet_wrap()en Visual Studio Code. ¿Qué hacenrow? ¿Qué hacencol? ¿Qué otras opciones controlan la disposición de los paneles individuales? ¿Por quéfacet_grid()no tiene los argumentosnrowyncol?Recrea el siguiente gráfico usando
facet_wrap()en lugar defacet_grid(). ¿Cómo cambian las posiciones de las etiquetas de las facetas?( ggplot(mpg) + geom_point(aes(x = "displ", y = "hwy")) + facet_grid("drv") )
Transformaciones estadísticas
Considera un gráfico de barras básico, dibujado con geom_bar() o geom_col(). El siguiente gráfico muestra el número total de diamantes del dataset diamonds, agrupados por cut. El dataset diamonds contiene información sobre ~54.000 diamantes, incluidos el price, carat, color, clarity y cut de cada diamante. Lo cargaremos en un momento. El gráfico muestra que hay más diamantes disponibles con cortes de alta calidad que con cortes de baja calidad.
diamonds = pd.read_csv(
    "https://vincentarelbundock.github.io/Rdatasets/csv/ggplot2/diamonds.csv",
    index_col=0,
)
diamonds_cut_order = ["Fair", "Good", "Very Good", "Premium", "Ideal"]
diamonds["cut"] = diamonds["cut"].astype(
    pd.CategoricalDtype(categories=diamonds_cut_order, ordered=True)
)
diamonds.head()| carat | cut | color | clarity | depth | table | price | x | y | z | |
|---|---|---|---|---|---|---|---|---|---|---|
| rownames | ||||||||||
| 1 | 0.23 | Ideal | E | SI2 | 61.5 | 55.0 | 326 | 3.95 | 3.98 | 2.43 |
| 2 | 0.21 | Premium | E | SI1 | 59.8 | 61.0 | 326 | 3.89 | 3.84 | 2.31 |
| 3 | 0.23 | Good | E | VS1 | 56.9 | 65.0 | 327 | 4.05 | 4.07 | 2.31 |
| 4 | 0.29 | Premium | I | VS2 | 62.4 | 58.0 | 334 | 4.20 | 4.23 | 2.63 |
| 5 | 0.31 | Good | J | SI2 | 63.3 | 58.0 | 335 | 4.34 | 4.35 | 2.75 |
(ggplot(diamonds, aes(x="cut")) + geom_bar())En el eje x, el gráfico muestra cut, una variable de diamonds. En el eje y, muestra el conteo, ¡pero el conteo no es una variable de diamonds! ¿De dónde sale el conteo? Muchos gráficos, como los scatter plots, representan los valores brutos de tu dataset. Otros gráficos, como los de barras, calculan nuevos valores para representar:
Los gráficos de barras, los histogramas y los polígonos de frecuencia agrupan tus datos en intervalos (bins) y luego representan el conteo de cada intervalo, es decir, el número de puntos que caen en cada uno.
Los suavizadores ajustan un modelo a tus datos y luego representan las predicciones del modelo.
Los boxplots calculan el resumen de cinco números de la distribución y luego muestran ese resumen como una caja con un formato especial.
El algoritmo que se usa para calcular los nuevos valores de un gráfico se llama stat, abreviatura de transformación estadística (statistical transformation). La figura siguiente muestra cómo funciona este proceso con geom_bar().
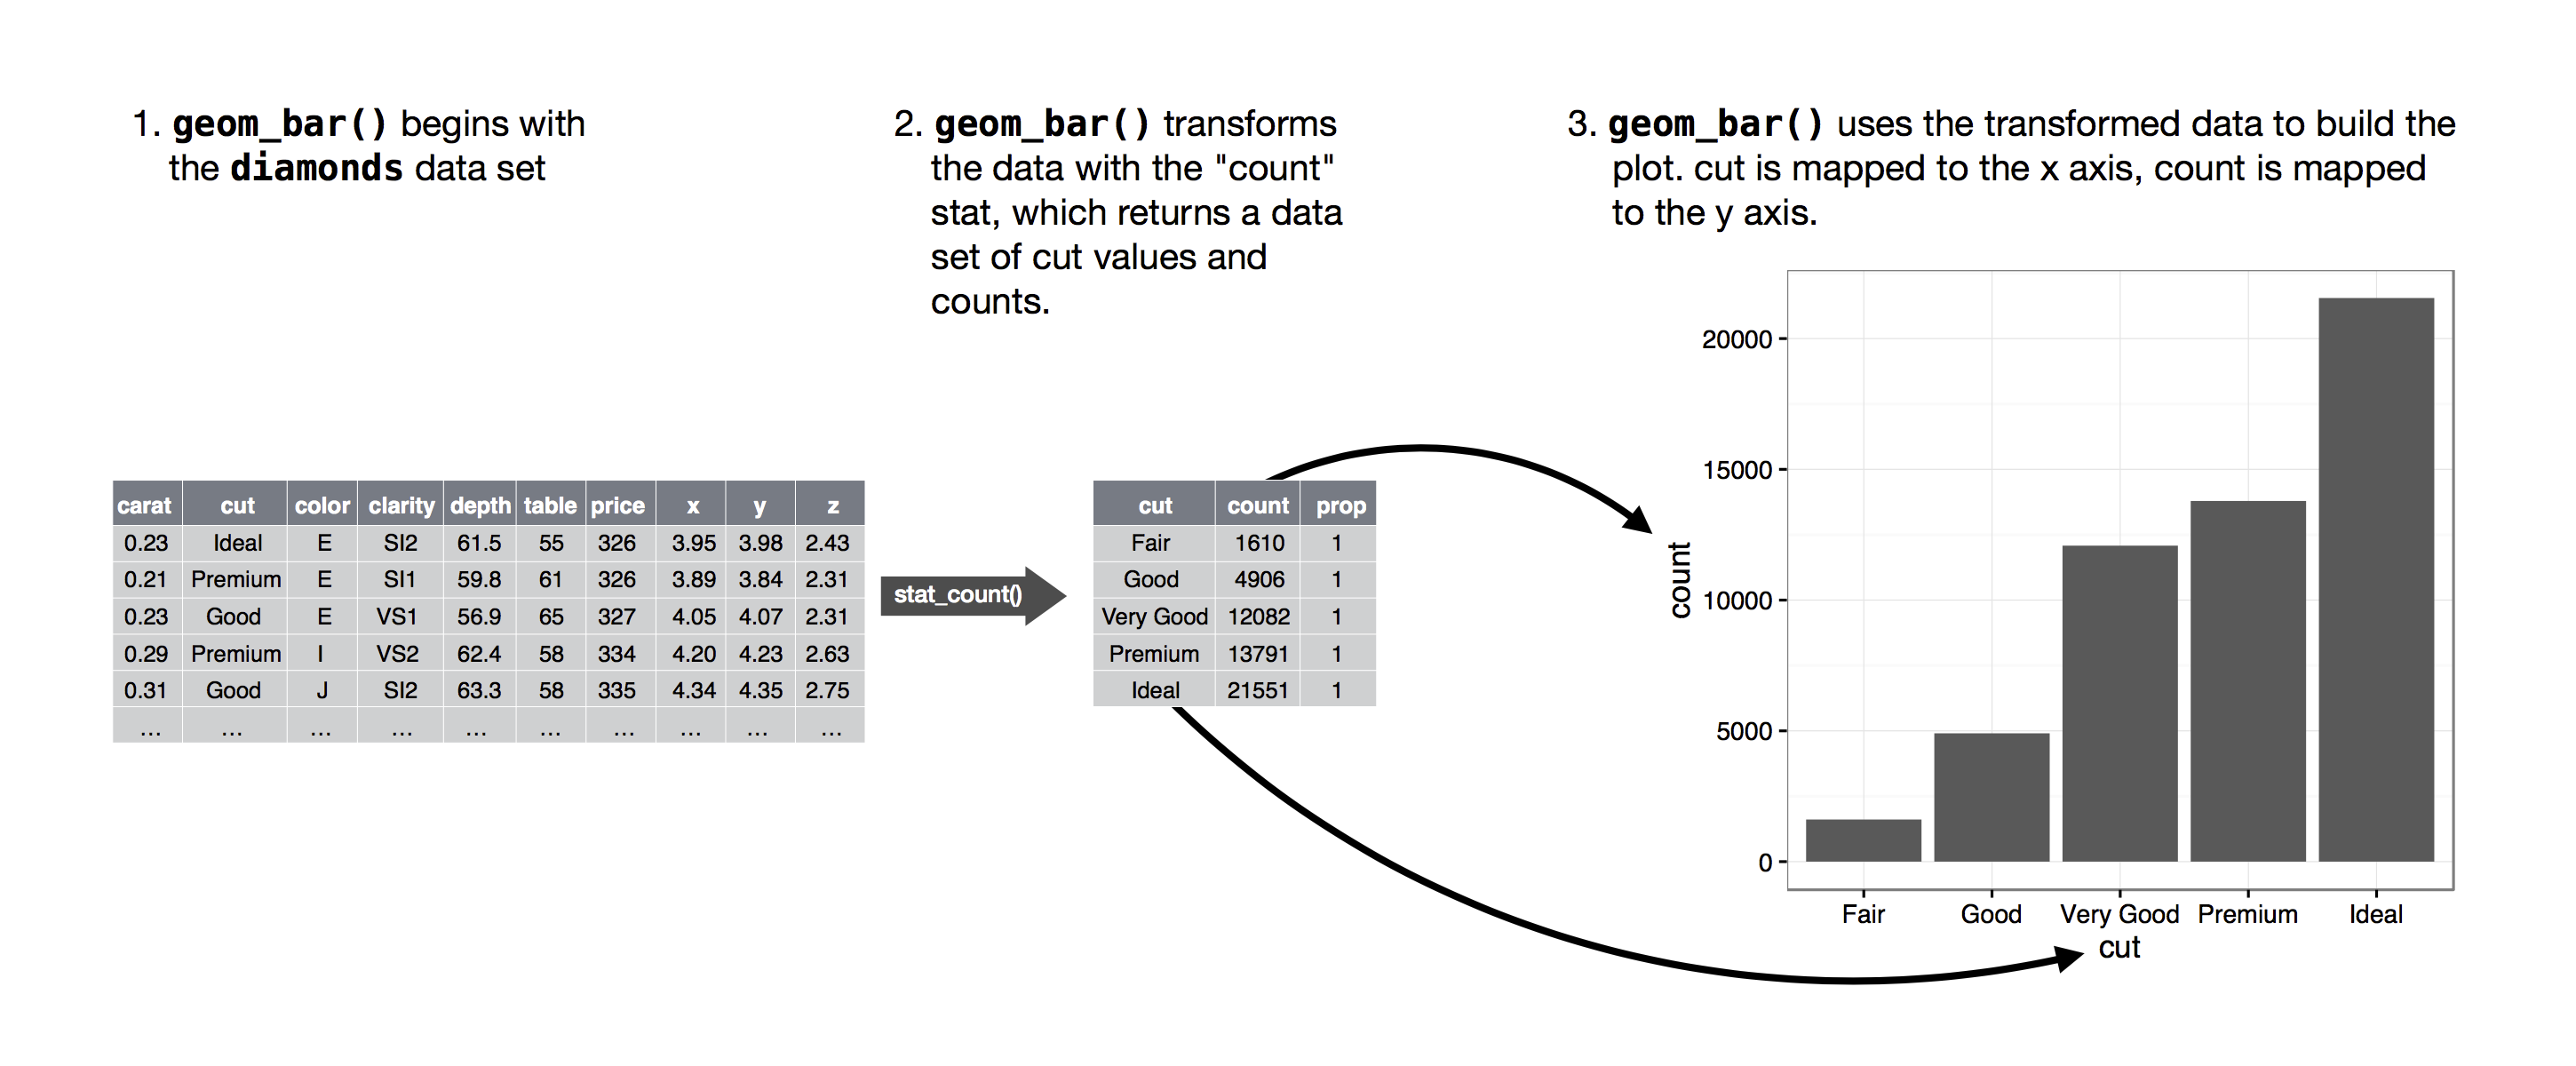
Puedes saber qué stat usa un geom inspeccionando el valor predeterminado del argumento stat. Por ejemplo, help(geom_bar) (o pasar el ratón por encima de la función escrita en el código) muestra que el valor predeterminado de stat es “count”, lo que significa que geom_bar() usa el conteo del número de ocurrencias.
Cada geom tiene un stat predeterminado, y cada stat tiene un geom predeterminado. Esto significa que normalmente puedes usar los geoms sin preocuparte por la transformación estadística subyacente. Sin embargo, hay algunas razones por las que podrías necesitar usar un stat de forma explícita; por ejemplo, podrías querer sustituir el stat predeterminado. En el código siguiente, cambiamos el stat de geom_bar() de count (el predeterminado) a identity. Esto nos permite asignar la altura de las barras a los valores brutos de una variable y.
(
    ggplot(
        diamonds.value_counts("cut").reset_index(name="counts"),
        aes(x="cut", y="counts"),
    )
    + geom_bar(stat="identity")
)
Ajustes de posición
Hay otra pieza de magia asociada a los gráficos de barras. Puedes colorear un gráfico de barras usando la estética color o, lo que es más útil, la estética fill:
(ggplot(mpg, aes(x="drv", color="drv")) + geom_bar())(ggplot(mpg, aes(x="drv", fill="drv")) + geom_bar())Fíjate en lo que ocurre si asignas la estética fill a otra variable, como class: las barras se apilan automáticamente. Cada rectángulo coloreado representa una combinación de drv y class.
(ggplot(mpg, aes(x="drv", fill="class")) + geom_bar())El apilado se realiza automáticamente mediante el ajuste de posición especificado por el argumento position. Si no quieres un gráfico de barras apiladas, puedes usar una de otras tres opciones: "identity", "dodge" o "fill".
position = "identity"colocará cada objeto exactamente donde le corresponde en el contexto del gráfico. Esto no es muy útil para las barras, porque las superpone. Para ver esa superposición, normalmente necesitamos hacer las barras ligeramente transparentes estableciendoalphaen un valor pequeño.
(ggplot(mpg, aes(x="drv", fill="class")) + geom_bar(alpha=0.5, position="identity"))El ajuste de posición identity es más útil para geoms 2D, como los puntos, donde es el predeterminado.
position = "fill"funciona como el apilado, pero hace que cada conjunto de barras apiladas tenga la misma altura. Esto facilita comparar proporciones entre grupos.
(ggplot(mpg, aes(x="drv", fill="class")) + geom_bar(position="fill"))position = "dodge"coloca los objetos superpuestos directamente uno al lado del otro. Esto facilita comparar valores individuales.
(ggplot(mpg, aes(x="drv", fill="class")) + geom_bar(position="dodge"))Hay otro tipo de ajuste que no es útil para los gráficos de barras, pero que puede ser muy útil para los scatter plots. Recuerda nuestro primer scatter plot. ¿Te diste cuenta de que el gráfico muestra solo algunos de los puntos (aunque hay 234 observaciones en el dataset)?
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point())Los valores subyacentes de hwy y displ están redondeados, de modo que los puntos aparecen en una cuadrícula y muchos se superponen entre sí. Este problema se conoce como sobretrazado (overplotting). Esta disposición dificulta ver la distribución de los datos. ¿Están los puntos repartidos por igual en todo el gráfico, o hay una combinación especial de hwy y displ que contiene 109 valores?
Puedes evitar esta cuadrícula estableciendo el ajuste de posición en “jitter”. position = "jitter" añade una pequeña cantidad de ruido aleatorio a cada punto. Esto dispersa los puntos, ya que es poco probable que dos puntos reciban la misma cantidad de ruido aleatorio.
(ggplot(mpg, aes(x="displ", y="hwy")) + geom_point(position="jitter"))Añadir aleatoriedad parece una forma extraña de mejorar tu gráfico, pero, aunque lo hace menos preciso a escalas pequeñas, lo hace más revelador a escalas grandes.
Como es una operación tan útil, letsplot incluye un atajo para geom_point(position = "jitter"): geom_jitter().
Por supuesto, una forma más sofisticada de abordar el sobretrazado es mediante un gráfico binscatter, disponible en el paquete binsreg.
Para saber más sobre los ajustes de posición, consulta la documentación.
Ejercicios
- ¿Cuál es el problema del siguiente gráfico? ¿Cómo podrías mejorarlo?
(ggplot(mpg, aes(x="cty", y="hwy")) + geom_point())¿Hay alguna diferencia entre los dos gráficos? Si es así, ¿cuál? ¿Por qué?
(
    ggplot(mpg, aes(x = "displ", y = "hwy")) +
      geom_point()
)
(
    ggplot(mpg, aes(x = "displ", y = "hwy")) +
      geom_point(position = "identity")
)
¿Qué parámetros de
geom_jitter()controlan la cantidad de jitter?¿Cuál es el ajuste de posición predeterminado de
geom_boxplot()? Crea una visualización del datasetmpgque lo demuestre.
La gramática de gráficos por capas
Podemos ampliar la plantilla de gráficos que ya aprendiste añadiendo ajustes de posición, stats, sistemas de coordenadas y facetas:
ggplot(data = <DATA>) +
  <GEOM_FUNCTION>(
     mapping = aes(<MAPPINGS>),
     stat = <STAT>,
     position = <POSITION>
  ) +
  <FACET_FUNCTION>
Nuestra nueva plantilla admite seis parámetros, las palabras entre corchetes que aparecen en ella. En la práctica, rara vez necesitas proporcionar los siete parámetros para crear un gráfico, porque lets-plot proporcionará valores predeterminados útiles para todo excepto los datos, las asignaciones y la función geom.
Los seis parámetros de la plantilla componen la gramática de gráficos, un sistema formal para construir gráficos. La gramática de gráficos se basa en la idea de que puedes describir de forma única cualquier gráfico como una combinación de un dataset, un geom, un conjunto de asignaciones, un stat, un ajuste de posición, un sistema de coordenadas, un esquema de facetas y un tema.
Para ver cómo funciona, piensa en cómo podrías construir un gráfico básico desde cero: podrías empezar con un dataset y luego transformarlo en la información que quieres mostrar (con un stat). A continuación, podrías elegir un objeto geométrico para representar cada observación de los datos transformados. Luego podrías usar las propiedades estéticas de los geoms para representar variables de los datos. Asignarías los valores de cada variable a los niveles de una estética. Estos pasos se ilustran en la figura siguiente.
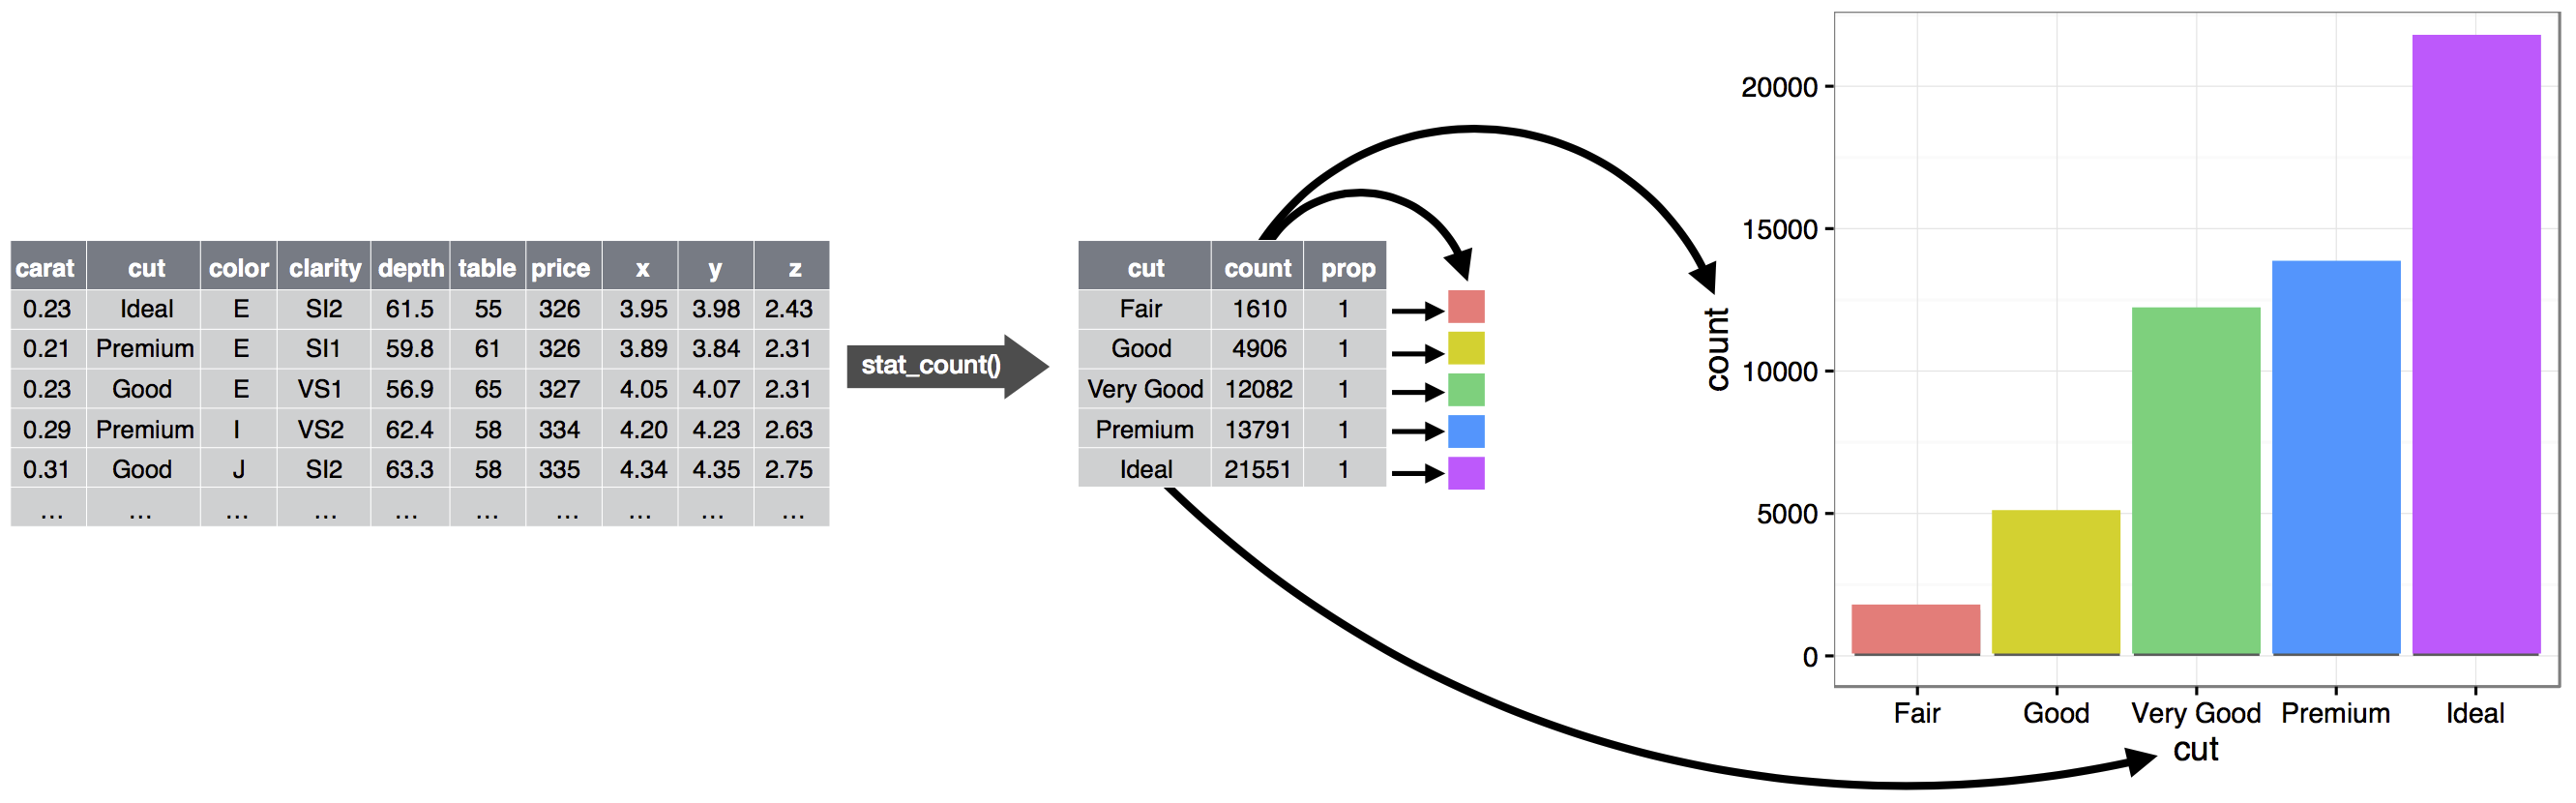
En este punto, tendrías un gráfico completo, pero podrías ajustar aún más las posiciones de los geoms dentro del sistema de coordenadas (un ajuste de posición) o dividir el gráfico en subgráficos (facetas). También podrías ampliar el gráfico añadiendo una o más capas adicionales, donde cada capa adicional usa un dataset, un geom, un conjunto de asignaciones, un stat y un ajuste de posición.
Podrías usar este método para crear muchos de los gráficos que puedas imaginar.
Resumen
En este capítulo aprendiste la gramática de gráficos por capas: empezando por las estéticas y las geometrías para construir un gráfico sencillo, las facetas para dividir el gráfico en subconjuntos, los stats para entender cómo se calculan los geoms, los ajustes de posición para controlar los detalles finos de la posición cuando los geoms podrían superponerse, y los sistemas de coordenadas, que te permiten cambiar de forma fundamental lo que significan x e y.
El recurso adicional más útil sobre lets-plot es su documentación, que puedes encontrar aquí.