import pandas as pdTransformación de datos
Introducción
Es muy raro que los datos lleguen exactamente en la forma que necesitas. A menudo tendrás que crear algunas variables o resúmenes nuevos, o quizá solo quieras renombrar las variables o reordenar las observaciones para que sea un poco más fácil trabajar con los datos.
En este capítulo aprenderás a hacer todo eso (¡y más!). Te presentaremos la transformación de datos con el paquete pandas y un nuevo dataset sobre los vuelos que salieron de la ciudad de Nueva York en 2013.
El objetivo de este capítulo es darte una visión general de todas las herramientas clave para transformar un dataframe, un tipo especial de objeto que contiene datos tabulares.
Volveremos a estas funciones con más detalle en capítulos posteriores, cuando empecemos a profundizar en tipos de datos específicos (p. ej., números, strings, fechas).
Requisitos previos
En este capítulo nos centraremos en el paquete pandas, una de las herramientas más utilizadas en ciencia de datos. Tendrás que asegurarte de tener pandas instalado. Para ello, puedes ejecutar
Si este comando falla, no tienes pandas instalado. Abre la terminal en Visual Studio Code (Terminal -> New Terminal), usa cd para ir a la carpeta en la que estás trabajando y escribe uv add pandas.
Además, si quieres comprobar qué versión de pandas estás usando, se hace así
pd.__version__'2.2.3'También necesitarás los datos. La mayoría de las veces, los datos tendrán que cargarse desde un archivo o desde internet. Estos datos no son una excepción, pero una de las cosas increíbles de pandas es la cantidad de tipos de datos distintos que puede cargar, incluso desde archivos en internet.
Los datos ocupan unos 50 MB, así que necesitarás una buena conexión a internet o un poco de paciencia para que se descarguen.
Descarguemos los datos:
url = "https://raw.githubusercontent.com/byuidatascience/data4python4ds/master/data-raw/flights/flights.csv"
flights = pd.read_csv(url)
Si el código anterior funcionó, habrás descargado los datos en formato CSV y los habrás guardado en un dataframe. Veamos las primeras filas con la función .head(), que funciona con todos los dataframes de pandas.
flights.head()| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | flight | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 517.0 | 515 | 2.0 | 830.0 | 819 | 11.0 | UA | 1545 | N14228 | EWR | IAH | 227.0 | 1400 | 5 | 15 | 2013-01-01T10:00:00Z |
| 1 | 2013 | 1 | 1 | 533.0 | 529 | 4.0 | 850.0 | 830 | 20.0 | UA | 1714 | N24211 | LGA | IAH | 227.0 | 1416 | 5 | 29 | 2013-01-01T10:00:00Z |
| 2 | 2013 | 1 | 1 | 542.0 | 540 | 2.0 | 923.0 | 850 | 33.0 | AA | 1141 | N619AA | JFK | MIA | 160.0 | 1089 | 5 | 40 | 2013-01-01T10:00:00Z |
| 3 | 2013 | 1 | 1 | 544.0 | 545 | -1.0 | 1004.0 | 1022 | -18.0 | B6 | 725 | N804JB | JFK | BQN | 183.0 | 1576 | 5 | 45 | 2013-01-01T10:00:00Z |
| 4 | 2013 | 1 | 1 | 554.0 | 600 | -6.0 | 812.0 | 837 | -25.0 | DL | 461 | N668DN | LGA | ATL | 116.0 | 762 | 6 | 0 | 2013-01-01T11:00:00Z |
Para obtener información más general sobre las columnas, los tipos de datos (dtypes) de las columnas y el tamaño del dataset, usa .info().
flights.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 336776 entries, 0 to 336775
Data columns (total 19 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 year 336776 non-null int64
1 month 336776 non-null int64
2 day 336776 non-null int64
3 dep_time 328521 non-null float64
4 sched_dep_time 336776 non-null int64
5 dep_delay 328521 non-null float64
6 arr_time 328063 non-null float64
7 sched_arr_time 336776 non-null int64
8 arr_delay 327346 non-null float64
9 carrier 336776 non-null object
10 flight 336776 non-null int64
11 tailnum 334264 non-null object
12 origin 336776 non-null object
13 dest 336776 non-null object
14 air_time 327346 non-null float64
15 distance 336776 non-null int64
16 hour 336776 non-null int64
17 minute 336776 non-null int64
18 time_hour 336776 non-null object
dtypes: float64(5), int64(9), object(5)
memory usage: 48.8+ MBQuizá hayas notado las abreviaturas cortas que aparecen en la columna Dtypes. Indican el tipo de los valores de sus respectivas columnas: int64 es la abreviatura de entero (es decir, números enteros) y float64 es la abreviatura de número de punto flotante de doble precisión (números reales). object es una especie de categoría comodín para cualquier tipo de dato que pandas no se atreve a inferir con seguridad. Aunque no aparecen aquí, otros tipos de datos son string para texto y datetime para combinaciones de fecha y hora.
La siguiente tabla muestra algunos de los tipos de datos más comunes que probablemente encontrarás.
| Nombre del tipo de dato | Tipo de dato |
|---|---|
| float64 | números reales |
| category | categorías |
| datetime64 | fechas y horas |
| int64 | enteros |
| bool | True o False |
| string | texto |
Los distintos tipos de datos de las columnas son importantes porque las operaciones que puedes realizar en una columna dependen mucho de su “tipo”; por ejemplo, puedes eliminar todos los signos de puntuación de los strings, mientras que puedes multiplicar ints y floats.
Nos gustaría trabajar con la variable "time_hour" en forma de datetime; por suerte, pandas facilita realizar esa conversión en esa columna concreta
flights["time_hour"]0 2013-01-01T10:00:00Z
1 2013-01-01T10:00:00Z
2 2013-01-01T10:00:00Z
3 2013-01-01T10:00:00Z
4 2013-01-01T11:00:00Z
...
336771 2013-09-30T18:00:00Z
336772 2013-10-01T02:00:00Z
336773 2013-09-30T16:00:00Z
336774 2013-09-30T15:00:00Z
336775 2013-09-30T12:00:00Z
Name: time_hour, Length: 336776, dtype: objectflights["time_hour"] = pd.to_datetime(flights["time_hour"], format="%Y-%m-%dT%H:%M:%SZ")Conceptos básicos de pandas
pandas es un paquete realmente completo, y este libro apenas rozará la superficie de lo que puede hacer. Pero está construido en torno a unas pocas ideas sencillas que, una vez que las entiendes, te facilitan mucho la vida.
Empecemos por lo más básico. El objeto más básico de pandas es el DataFrame. Un DataFrame es una estructura de datos bidimensional que puede almacenar datos de distintos tipos (incluidos caracteres, enteros, valores de punto flotante, datos categóricos e incluso listas) en columnas. Está formado por filas y columnas (cada celda fila-columna contiene un valor), más dos elementos de información contextual: el índice (que contiene información sobre cada fila) y los nombres de las columnas (que contienen información sobre cada columna).

Quizá la noción más importante sobre los dataframes de pandas es que están construidos en torno a un índice situado en el lado izquierdo del dataframe. Cada vez que realizas una operación sobre un dataframe, tienes que pensar en cómo podría afectar o no al índice; o, dicho de otro modo, si quieres modificar el índice.
Veamos un ejemplo sencillo de esto con un dataframe inventado:
df = pd.DataFrame(
    data={
        "col0": [0, 0, 0, 0],
        "col1": [0, 0, 0, 0],
        "col2": [0, 0, 0, 0],
        "col3": ["a", "b", "b", "a"],
        "col4": ["alpha", "gamma", "gamma", "gamma"],
    },
    index=["row" + str(i) for i in range(4)],
)
df.head()| col0 | col1 | col2 | col3 | col4 | |
|---|---|---|---|---|---|
| row0 | 0 | 0 | 0 | a | alpha |
| row1 | 0 | 0 | 0 | b | gamma |
| row2 | 0 | 0 | 0 | b | gamma |
| row3 | 0 | 0 | 0 | a | gamma |
Puedes ver que hay 5 columnas (llamadas de "col0" a "col4") y que el índice consta de cuatro entradas llamadas de "row0" a "row3".
Un segundo punto clave que debes conocer es que las operaciones sobre un dataframe de pandas se pueden encadenar. No necesitamos hacer una asignación por línea de código; de hecho, podemos hacer varias asignaciones en un solo comando.
Veamos un ejemplo. Vamos a encadenar cuatro operaciones:
- usaremos
query()para encontrar solo las filas en las que la columna de destino"dest"tiene el valor"IAH". Esto no cambia el índice, solo elimina las filas irrelevantes. En efecto, este paso elimina las filas que no nos interesan. - usaremos
groupby()para agrupar las filas por año, mes y día (pasamos una lista de columnas a la funcióngroupby()). Este paso cambia el índice; el nuevo índice tendrá tres columnas que registran el año, el mes y el día. En efecto, este paso cambia el índice. - elegiremos qué columnas queremos conservar después de la operación
groupby()pasando una lista de ellas dentro de unos corchetes (los corchetes dobles se deben a que es una lista dentro de un dataframe). Aquí solo queremos una columna,"arr_delay". Esto no afecta al índice. En efecto, este paso elimina las columnas que no nos interesan. - por último, debemos especificar qué operación de
groupby()queremos aplicar; al agregar la información de varias filas en una sola, tenemos que indicar cómo debe agregarse esa información. En este caso, usaremosmean(). En efecto, este paso aplica un estadístico a la(s) variable(s) que seleccionamos antes, en los grupos que creamos antes.
(flights.query("dest == 'IAH'").groupby(["year", "month", "day"])[["arr_delay"]].mean())| arr_delay | |||
|---|---|---|---|
| year | month | day | |
| 2013 | 1 | 1 | 17.850000 |
| 2 | 7.000000 | ||
| 3 | 18.315789 | ||
| 4 | -3.200000 | ||
| 5 | 20.230769 | ||
| ... | ... | ... | |
| 12 | 27 | 6.166667 | |
| 28 | 9.500000 | ||
| 29 | 23.611111 | ||
| 30 | 23.684211 | ||
| 31 | -4.933333 |
365 rows × 1 columns
Aquí puedes ver que hemos creado un nuevo dataframe con un nuevo índice. Para ello, usamos cuatro operaciones clave:
- manipular filas
- manipular el índice
- manipular columnas
- aplicar estadísticos
Estas cubren la mayoría de las operaciones que podrías querer hacer sobre un único dataframe, pero hay distintas opciones para cada una según lo que necesites.
Profundicemos ahora un poco más en estas operaciones.
Manipulación de filas en dataframes
Creemos algunos datos ficticios para mostrar cómo funciona esto.
import numpy as np

df = pd.DataFrame(
    data=np.reshape(range(36), (6, 6)),
    index=["a", "b", "c", "d", "e", "f"],
    columns=["col" + str(i) for i in range(6)],
    dtype=float,
)
df["col6"] = ["apple", "orange", "pineapple", "mango", "kiwi", "lemon"]
df| col0 | col1 | col2 | col3 | col4 | col5 | col6 | |
|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon |
Acceso a filas
Para acceder directamente a una fila concreta, puedes usar df.loc['rowname'], o df.loc[['rowname1', 'rowname2']] para dos filas distintas.
Por ejemplo,
df.loc[["a", "b"]]| col0 | col1 | col2 | col3 | col4 | col5 | col6 | |
|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange |
Pero también puedes acceder a filas concretas según su posición en el dataframe usando .iloc. Recuerda que los índices en Python empiezan en cero, así que para obtener la primera fila usarías .iloc[0]:
df.iloc[0]col0 0.0
col1 1.0
col2 2.0
col3 3.0
col4 4.0
col5 5.0
col6 apple
Name: a, dtype: objectEsto también funciona con varias filas. Obtengamos la primera y la tercera fila (en las posiciones 0 y 2) pasando una lista de posiciones:
df.iloc[[0, 2]]| col0 | col1 | col2 | col3 | col4 | col5 | col6 | |
|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple |
Hay otras formas de acceder a varias filas que utilizan el slicing (rebanado), pero dejaremos ese tema para otro momento.
Filtrar filas con query
Como en el ejemplo de los vuelos, también podemos filtrar filas según una condición usando query():
df.query("col6 == 'kiwi' or col6 == 'pineapple'")| col0 | col1 | col2 | col3 | col4 | col5 | col6 | |
|---|---|---|---|---|---|---|---|
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi |
Para números, también puedes usar los signos de mayor que y menor que:
df.query("col0 > 6")| col0 | col1 | col2 | col3 | col4 | col5 | col6 | |
|---|---|---|---|---|---|---|---|
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon |
De hecho, hay muchas opciones que funcionan con query(): además de > (mayor que), puedes usar >= (mayor o igual que), < (menor que), <= (menor o igual que), == (igual a) y != (distinto de). También puedes usar los comandos and y or para combinar varias condiciones. Aquí tienes un ejemplo de and con el dataframe flights:
# Flights that departed on January 1
flights.query("month == 1 and day == 1")| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | flight | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 517.0 | 515 | 2.0 | 830.0 | 819 | 11.0 | UA | 1545 | N14228 | EWR | IAH | 227.0 | 1400 | 5 | 15 | 2013-01-01 10:00:00 |
| 1 | 2013 | 1 | 1 | 533.0 | 529 | 4.0 | 850.0 | 830 | 20.0 | UA | 1714 | N24211 | LGA | IAH | 227.0 | 1416 | 5 | 29 | 2013-01-01 10:00:00 |
| 2 | 2013 | 1 | 1 | 542.0 | 540 | 2.0 | 923.0 | 850 | 33.0 | AA | 1141 | N619AA | JFK | MIA | 160.0 | 1089 | 5 | 40 | 2013-01-01 10:00:00 |
| 3 | 2013 | 1 | 1 | 544.0 | 545 | -1.0 | 1004.0 | 1022 | -18.0 | B6 | 725 | N804JB | JFK | BQN | 183.0 | 1576 | 5 | 45 | 2013-01-01 10:00:00 |
| 4 | 2013 | 1 | 1 | 554.0 | 600 | -6.0 | 812.0 | 837 | -25.0 | DL | 461 | N668DN | LGA | ATL | 116.0 | 762 | 6 | 0 | 2013-01-01 11:00:00 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 837 | 2013 | 1 | 1 | 2356.0 | 2359 | -3.0 | 425.0 | 437 | -12.0 | B6 | 727 | N588JB | JFK | BQN | 186.0 | 1576 | 23 | 59 | 2013-01-02 04:00:00 |
| 838 | 2013 | 1 | 1 | NaN | 1630 | NaN | NaN | 1815 | NaN | EV | 4308 | N18120 | EWR | RDU | NaN | 416 | 16 | 30 | 2013-01-01 21:00:00 |
| 839 | 2013 | 1 | 1 | NaN | 1935 | NaN | NaN | 2240 | NaN | AA | 791 | N3EHAA | LGA | DFW | NaN | 1389 | 19 | 35 | 2013-01-02 00:00:00 |
| 840 | 2013 | 1 | 1 | NaN | 1500 | NaN | NaN | 1825 | NaN | AA | 1925 | N3EVAA | LGA | MIA | NaN | 1096 | 15 | 0 | 2013-01-01 20:00:00 |
| 841 | 2013 | 1 | 1 | NaN | 600 | NaN | NaN | 901 | NaN | B6 | 125 | N618JB | JFK | FLL | NaN | 1069 | 6 | 0 | 2013-01-01 11:00:00 |
842 rows × 19 columns
Ten en cuenta que la igualdad se comprueba con == y no con =, porque este último se usa para la asignación.
Reordenar filas
Una y otra vez querrás reordenar las filas de tu dataframe según los valores de una columna concreta. pandas lo hace muy fácil con la función .sort_values(). Recibe un dataframe y un conjunto de nombres de columnas por los que ordenar. Si proporcionas más de un nombre de columna, cada columna adicional se usará para desempatar los valores de las columnas anteriores. Por ejemplo, el siguiente código ordena por la hora de salida, que está repartida en cuatro columnas.
flights.sort_values(["year", "month", "day", "dep_time"])| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | flight | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 517.0 | 515 | 2.0 | 830.0 | 819 | 11.0 | UA | 1545 | N14228 | EWR | IAH | 227.0 | 1400 | 5 | 15 | 2013-01-01 10:00:00 |
| 1 | 2013 | 1 | 1 | 533.0 | 529 | 4.0 | 850.0 | 830 | 20.0 | UA | 1714 | N24211 | LGA | IAH | 227.0 | 1416 | 5 | 29 | 2013-01-01 10:00:00 |
| 2 | 2013 | 1 | 1 | 542.0 | 540 | 2.0 | 923.0 | 850 | 33.0 | AA | 1141 | N619AA | JFK | MIA | 160.0 | 1089 | 5 | 40 | 2013-01-01 10:00:00 |
| 3 | 2013 | 1 | 1 | 544.0 | 545 | -1.0 | 1004.0 | 1022 | -18.0 | B6 | 725 | N804JB | JFK | BQN | 183.0 | 1576 | 5 | 45 | 2013-01-01 10:00:00 |
| 4 | 2013 | 1 | 1 | 554.0 | 600 | -6.0 | 812.0 | 837 | -25.0 | DL | 461 | N668DN | LGA | ATL | 116.0 | 762 | 6 | 0 | 2013-01-01 11:00:00 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 111291 | 2013 | 12 | 31 | NaN | 705 | NaN | NaN | 931 | NaN | UA | 1729 | NaN | EWR | DEN | NaN | 1605 | 7 | 5 | 2013-12-31 12:00:00 |
| 111292 | 2013 | 12 | 31 | NaN | 825 | NaN | NaN | 1029 | NaN | US | 1831 | NaN | JFK | CLT | NaN | 541 | 8 | 25 | 2013-12-31 13:00:00 |
| 111293 | 2013 | 12 | 31 | NaN | 1615 | NaN | NaN | 1800 | NaN | MQ | 3301 | N844MQ | LGA | RDU | NaN | 431 | 16 | 15 | 2013-12-31 21:00:00 |
| 111294 | 2013 | 12 | 31 | NaN | 600 | NaN | NaN | 735 | NaN | UA | 219 | NaN | EWR | ORD | NaN | 719 | 6 | 0 | 2013-12-31 11:00:00 |
| 111295 | 2013 | 12 | 31 | NaN | 830 | NaN | NaN | 1154 | NaN | UA | 443 | NaN | JFK | LAX | NaN | 2475 | 8 | 30 | 2013-12-31 13:00:00 |
336776 rows × 19 columns
Puedes usar el argumento de palabra clave ascending=False para ordenar por una o varias columnas en orden descendente. Por ejemplo, este código muestra los vuelos con más retraso:
flights.sort_values("dep_delay", ascending=False)| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | flight | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 7072 | 2013 | 1 | 9 | 641.0 | 900 | 1301.0 | 1242.0 | 1530 | 1272.0 | HA | 51 | N384HA | JFK | HNL | 640.0 | 4983 | 9 | 0 | 2013-01-09 14:00:00 |
| 235778 | 2013 | 6 | 15 | 1432.0 | 1935 | 1137.0 | 1607.0 | 2120 | 1127.0 | MQ | 3535 | N504MQ | JFK | CMH | 74.0 | 483 | 19 | 35 | 2013-06-15 23:00:00 |
| 8239 | 2013 | 1 | 10 | 1121.0 | 1635 | 1126.0 | 1239.0 | 1810 | 1109.0 | MQ | 3695 | N517MQ | EWR | ORD | 111.0 | 719 | 16 | 35 | 2013-01-10 21:00:00 |
| 327043 | 2013 | 9 | 20 | 1139.0 | 1845 | 1014.0 | 1457.0 | 2210 | 1007.0 | AA | 177 | N338AA | JFK | SFO | 354.0 | 2586 | 18 | 45 | 2013-09-20 22:00:00 |
| 270376 | 2013 | 7 | 22 | 845.0 | 1600 | 1005.0 | 1044.0 | 1815 | 989.0 | MQ | 3075 | N665MQ | JFK | CVG | 96.0 | 589 | 16 | 0 | 2013-07-22 20:00:00 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 336771 | 2013 | 9 | 30 | NaN | 1455 | NaN | NaN | 1634 | NaN | 9E | 3393 | NaN | JFK | DCA | NaN | 213 | 14 | 55 | 2013-09-30 18:00:00 |
| 336772 | 2013 | 9 | 30 | NaN | 2200 | NaN | NaN | 2312 | NaN | 9E | 3525 | NaN | LGA | SYR | NaN | 198 | 22 | 0 | 2013-10-01 02:00:00 |
| 336773 | 2013 | 9 | 30 | NaN | 1210 | NaN | NaN | 1330 | NaN | MQ | 3461 | N535MQ | LGA | BNA | NaN | 764 | 12 | 10 | 2013-09-30 16:00:00 |
| 336774 | 2013 | 9 | 30 | NaN | 1159 | NaN | NaN | 1344 | NaN | MQ | 3572 | N511MQ | LGA | CLE | NaN | 419 | 11 | 59 | 2013-09-30 15:00:00 |
| 336775 | 2013 | 9 | 30 | NaN | 840 | NaN | NaN | 1020 | NaN | MQ | 3531 | N839MQ | LGA | RDU | NaN | 431 | 8 | 40 | 2013-09-30 12:00:00 |
336776 rows × 19 columns
Por supuesto, puedes combinar todas las manipulaciones de filas anteriores para resolver problemas más complejos. Por ejemplo, podríamos buscar los tres principales destinos de los vuelos que llegaron con más retraso y que salieron aproximadamente a tiempo:
(
    flights.query("dep_delay <= 10 and dep_delay >= -10")
    .sort_values("arr_delay", ascending=False)
    .iloc[[0, 1, 2]]
)| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | flight | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 55985 | 2013 | 11 | 1 | 658.0 | 700 | -2.0 | 1329.0 | 1015 | 194.0 | VX | 399 | N629VA | JFK | LAX | 336.0 | 2475 | 7 | 0 | 2013-11-01 11:00:00 |
| 181270 | 2013 | 4 | 18 | 558.0 | 600 | -2.0 | 1149.0 | 850 | 179.0 | AA | 707 | N3EXAA | LGA | DFW | 234.0 | 1389 | 6 | 0 | 2013-04-18 10:00:00 |
| 256340 | 2013 | 7 | 7 | 1659.0 | 1700 | -1.0 | 2050.0 | 1823 | 147.0 | US | 2183 | N948UW | LGA | DCA | 64.0 | 214 | 17 | 0 | 2013-07-07 21:00:00 |
Ejercicios
Encuentra todos los vuelos que
Tuvieron un retraso en la llegada de dos horas o más
Volaron a Houston (
"IAH"o"HOU")Fueron operados por United, American o Delta
Salieron en verano (julio, agosto y septiembre)
Llegaron con más de dos horas de retraso, pero no salieron tarde
Se retrasaron al menos una hora, pero recuperaron más de 30 minutos en vuelo
Ordena
flightspara encontrar los vuelos con los mayores retrasos en la salida.Ordena
flightspara encontrar los vuelos más rápidos¿Qué vuelos recorrieron la mayor distancia?
¿Importa el orden en que usas
query()ysort_values()si usas ambas? ¿Por qué sí o por qué no? Piensa en los resultados y en cuánto trabajo tendrían que hacer las funciones.
Manipulación de columnas
Esta sección te mostrará cómo aplicar a las columnas de tu dataframe las diversas operaciones que puedas necesitar.
Nota
Algunas operaciones de pandas pueden aplicarse a columnas o a filas, según la sintaxis que se use. Por ejemplo, el acceso a valores por posición funciona igual para filas y columnas mediante .iloc: para acceder a la i-ésima fila usarías df.iloc[i] y para acceder a la j-ésima columna usarías df.iloc[:, j], donde : significa ‘cualquier fila’.
Crear nuevas columnas
Pasemos ahora a crear nuevas columnas, ya sea con información nueva o a partir de columnas existentes. Dado un dataframe, df, crear una nueva columna con el mismo valor repetido es tan fácil como usar corchetes con un string (texto entre comillas) dentro.
df["new_column0"] = 5
df| col0 | col1 | col2 | col3 | col4 | col5 | col6 | new_column0 | |
|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 5 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 5 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 5 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 5 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 5 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 |
Si hacemos la misma operación otra vez, pero con un lado derecho distinto, se sobrescribirá lo que ya había en esa columna. Veámoslo con un ejemplo en el que ponemos valores diferentes en cada posición asignando una lista a la nueva columna.
df["new_column0"] = [0, 1, 2, 3, 4, 5]
df| col0 | col1 | col2 | col3 | col4 | col5 | col6 | new_column0 | |
|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 1 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 2 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 3 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 4 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 |
TipEjercicio
¿Qué ocurre si intentas hacer una asignación en la que los valores del lado derecho son más largos o más cortos que la longitud del dataframe?
Si pasamos una lista dentro de los corchetes, en realidad podemos crear más de una columna nueva:
df[["new_column1", "new_column2"]] = [5, 6]
df| col0 | col1 | col2 | col3 | col4 | col5 | col6 | new_column0 | new_column1 | new_column2 | |
|---|---|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 0 | 5 | 6 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 1 | 5 | 6 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 2 | 5 | 6 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 3 | 5 | 6 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 4 | 5 | 6 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 | 5 | 6 |
Muy a menudo querrás crear una nueva columna que sea el resultado de una operación sobre columnas existentes. Hay un par de formas de hacerlo. El método ‘independiente’ funciona de forma similar a lo que acabamos de ver, salvo que también hacemos referencia al dataframe en el lado derecho de la sentencia de asignación:
df["new_column3"] = df["col0"] - df["new_column0"]
df| col0 | col1 | col2 | col3 | col4 | col5 | col6 | new_column0 | new_column1 | new_column2 | new_column3 | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 0 | 5 | 6 | 0.0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 1 | 5 | 6 | 5.0 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 2 | 5 | 6 | 10.0 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 3 | 5 | 6 | 15.0 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 4 | 5 | 6 | 20.0 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 | 5 | 6 | 25.0 |
La otra forma de hacerlo implica una sentencia ‘assign()’ y se usa cuando quieres encadenar varios pasos (como vimos antes). Estas usan una sintaxis especial llamada sentencia ‘lambda’, que (al menos aquí) simplemente proporciona una forma de indicarle a pandas que queremos realizar la operación en cada fila. A continuación tienes un ejemplo con los datos de vuelos. Ten en cuenta, eso sí, que la palabra ‘row’ de abajo es un marcador; podrías sustituirla por cualquier nombre de variable (por ejemplo, x), pero row hace que lo que ocurre sea un poco más claro.
(
    flights.assign(
        gain=lambda row: row["dep_delay"] - row["arr_delay"],
        speed=lambda row: row["distance"] / row["air_time"] * 60,
    )
)| year | month | day | dep_time | sched_dep_time | dep_delay | arr_time | sched_arr_time | arr_delay | carrier | ... | tailnum | origin | dest | air_time | distance | hour | minute | time_hour | gain | speed | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 517.0 | 515 | 2.0 | 830.0 | 819 | 11.0 | UA | ... | N14228 | EWR | IAH | 227.0 | 1400 | 5 | 15 | 2013-01-01 10:00:00 | -9.0 | 370.044053 |
| 1 | 2013 | 1 | 1 | 533.0 | 529 | 4.0 | 850.0 | 830 | 20.0 | UA | ... | N24211 | LGA | IAH | 227.0 | 1416 | 5 | 29 | 2013-01-01 10:00:00 | -16.0 | 374.273128 |
| 2 | 2013 | 1 | 1 | 542.0 | 540 | 2.0 | 923.0 | 850 | 33.0 | AA | ... | N619AA | JFK | MIA | 160.0 | 1089 | 5 | 40 | 2013-01-01 10:00:00 | -31.0 | 408.375000 |
| 3 | 2013 | 1 | 1 | 544.0 | 545 | -1.0 | 1004.0 | 1022 | -18.0 | B6 | ... | N804JB | JFK | BQN | 183.0 | 1576 | 5 | 45 | 2013-01-01 10:00:00 | 17.0 | 516.721311 |
| 4 | 2013 | 1 | 1 | 554.0 | 600 | -6.0 | 812.0 | 837 | -25.0 | DL | ... | N668DN | LGA | ATL | 116.0 | 762 | 6 | 0 | 2013-01-01 11:00:00 | 19.0 | 394.137931 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 336771 | 2013 | 9 | 30 | NaN | 1455 | NaN | NaN | 1634 | NaN | 9E | ... | NaN | JFK | DCA | NaN | 213 | 14 | 55 | 2013-09-30 18:00:00 | NaN | NaN |
| 336772 | 2013 | 9 | 30 | NaN | 2200 | NaN | NaN | 2312 | NaN | 9E | ... | NaN | LGA | SYR | NaN | 198 | 22 | 0 | 2013-10-01 02:00:00 | NaN | NaN |
| 336773 | 2013 | 9 | 30 | NaN | 1210 | NaN | NaN | 1330 | NaN | MQ | ... | N535MQ | LGA | BNA | NaN | 764 | 12 | 10 | 2013-09-30 16:00:00 | NaN | NaN |
| 336774 | 2013 | 9 | 30 | NaN | 1159 | NaN | NaN | 1344 | NaN | MQ | ... | N511MQ | LGA | CLE | NaN | 419 | 11 | 59 | 2013-09-30 15:00:00 | NaN | NaN |
| 336775 | 2013 | 9 | 30 | NaN | 840 | NaN | NaN | 1020 | NaN | MQ | ... | N839MQ | LGA | RDU | NaN | 431 | 8 | 40 | 2013-09-30 12:00:00 | NaN | NaN |
336776 rows × 21 columns
Nota
Una función lambda es como cualquier función normal de Python, salvo que no tiene nombre y suele escribirse en una sola línea de código. Una función lambda consta de un argumento, dos puntos y una expresión, como la siguiente función lambda, que multiplica una entrada por tres.
lambda x: x*3Acceder a columnas
Al igual que al seleccionar filas, hay muchas opciones y formas de seleccionar las columnas sobre las que operar. La de sintaxis más sencilla es el nombre del dataframe seguido de corchetes y el nombre de la columna (como string)
df["col0"]a 0.0
b 6.0
c 12.0
d 18.0
e 24.0
f 30.0
Name: col0, dtype: float64Si necesitas seleccionar varias columnas, no puedes pasar simplemente un string a df[...]; en su lugar, debes pasar un objeto iterable (y que, por tanto, tenga varios elementos). La forma más directa de seleccionar varias columnas es pasar una lista. Recuerda que las listas van entre corchetes, así que veremos algo con corchetes repetidos: unos para acceder al interior del dataframe y otros para la lista.
df[["col0", "new_column0", "col2"]]| col0 | new_column0 | col2 | |
|---|---|---|---|
| a | 0.0 | 0 | 2.0 |
| b | 6.0 | 1 | 8.0 |
| c | 12.0 | 2 | 14.0 |
| d | 18.0 | 3 | 20.0 |
| e | 24.0 | 4 | 26.0 |
| f | 30.0 | 5 | 32.0 |
Si quieres acceder a filas concretas al mismo tiempo, usa la función de acceso .loc:
df.loc[["a", "b"], ["col0", "new_column0", "col2"]]| col0 | new_column0 | col2 | |
|---|---|---|---|
| a | 0.0 | 0 | 2.0 |
| b | 6.0 | 1 | 8.0 |
Y, al igual que con las filas, podemos acceder a las columnas por su posición usando .iloc (donde : representa ‘cualquier fila’).
df.iloc[:, [0, 1]]| col0 | col1 | |
|---|---|---|
| a | 0.0 | 1.0 |
| b | 6.0 | 7.0 |
| c | 12.0 | 13.0 |
| d | 18.0 | 19.0 |
| e | 24.0 | 25.0 |
| f | 30.0 | 31.0 |
Hay otras formas de acceder a varias columnas que usan slicing (rebanado), pero dejaremos ese tema para otro momento.
A veces querrás seleccionar columnas según el tipo de datos que contienen. Para ello, pandas proporciona la función .select_dtypes(). Usémosla para seleccionar todas las columnas con enteros en los datos de vuelos.
flights.select_dtypes("int")| year | month | day | sched_dep_time | sched_arr_time | flight | distance | hour | minute | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 515 | 819 | 1545 | 1400 | 5 | 15 |
| 1 | 2013 | 1 | 1 | 529 | 830 | 1714 | 1416 | 5 | 29 |
| 2 | 2013 | 1 | 1 | 540 | 850 | 1141 | 1089 | 5 | 40 |
| 3 | 2013 | 1 | 1 | 545 | 1022 | 725 | 1576 | 5 | 45 |
| 4 | 2013 | 1 | 1 | 600 | 837 | 461 | 762 | 6 | 0 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 336771 | 2013 | 9 | 30 | 1455 | 1634 | 3393 | 213 | 14 | 55 |
| 336772 | 2013 | 9 | 30 | 2200 | 2312 | 3525 | 198 | 22 | 0 |
| 336773 | 2013 | 9 | 30 | 1210 | 1330 | 3461 | 764 | 12 | 10 |
| 336774 | 2013 | 9 | 30 | 1159 | 1344 | 3572 | 419 | 11 | 59 |
| 336775 | 2013 | 9 | 30 | 840 | 1020 | 3531 | 431 | 8 | 40 |
336776 rows × 9 columns
En otras ocasiones querrás seleccionar columnas según criterios como patrones en el nombre de la columna. Como Python tiene muy buen soporte para texto, esto es muy posible, pero no suele estar tan integrado en las funciones de pandas. El truco consiste en generar una lista con los nombres de columna que quieres a partir del patrón que te interesa.
Veamos un par de ejemplos. Primero, obtengamos todas las columnas de nuestro dataframe df que empiezan por "new_...". Generaremos una lista de valores verdaderos y falsos que indican si cada columna empieza por “new” y luego pasaremos esos valores a .loc, que solo devolverá las columnas cuyo resultado fue True. Para mostrar lo que ocurre, lo dividiremos en dos pasos:
print("The list of columns:")
print(df.columns)
print("\n")

print("The list of true and false values:")
print(df.columns.str.startswith("new"))
print("\n")

print("The selection from the data frame:")
df.loc[:, df.columns.str.startswith("new")]
The list of columns:
Index(['col0', 'col1', 'col2', 'col3', 'col4', 'col5', 'col6', 'new_column0',
'new_column1', 'new_column2', 'new_column3'],
dtype='object')
The list of true and false values:
[False False False False False False False True True True True]
The selection from the data frame:| new_column0 | new_column1 | new_column2 | new_column3 | |
|---|---|---|---|---|
| a | 0 | 5 | 6 | 0.0 |
| b | 1 | 5 | 6 | 5.0 |
| c | 2 | 5 | 6 | 10.0 |
| d | 3 | 5 | 6 | 15.0 |
| e | 4 | 5 | 6 | 20.0 |
| f | 5 | 5 | 6 | 25.0 |
Además de startswith(), hay otros comandos como endswith(), contains(), isnumeric() e islower().
Renombrar columnas
Hay tres formas sencillas de renombrar columnas, según el contexto. La primera es usar la función específica rename() con un objeto llamado diccionario. Los diccionarios en Python constan de llaves con pares de valores separados por comas, donde el primer valor se asigna al segundo. Un ejemplo de diccionario sería {'old_col1': 'new_col1', 'old_col2': 'new_col2'}. Veámoslo en la práctica (pero ten en cuenta que no estamos ‘guardando’ el dataframe resultante, solo mostrándolo; para guardarlo, tendrías que añadir df = al lado izquierdo del código de abajo).
df.rename(columns={"col3": "letters", "col4": "names", "col6": "fruit"})| col0 | col1 | col2 | letters | names | col5 | fruit | new_column0 | new_column1 | new_column2 | new_column3 | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 0 | 5 | 6 | 0.0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 1 | 5 | 6 | 5.0 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 2 | 5 | 6 | 10.0 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 3 | 5 | 6 | 15.0 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 4 | 5 | 6 | 20.0 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 | 5 | 6 | 25.0 |
El segundo método es para cuando quieres renombrar todas las columnas. Para ello, simplemente igualas df.columns al nuevo conjunto de columnas que quieras tener. Por ejemplo, podríamos querer poner en mayúscula la primera letra de cada columna usando str.capitalize() y asignarlo a df.columns.
df.columns = df.columns.str.capitalize()
df| Col0 | Col1 | Col2 | Col3 | Col4 | Col5 | Col6 | New_column0 | New_column1 | New_column2 | New_column3 | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 | apple | 0 | 5 | 6 | 0.0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 | orange | 1 | 5 | 6 | 5.0 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 | pineapple | 2 | 5 | 6 | 10.0 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 | mango | 3 | 5 | 6 | 15.0 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 | kiwi | 4 | 5 | 6 | 20.0 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 | lemon | 5 | 5 | 6 | 25.0 |
Por último, puede que solo nos interese reemplazar partes concretas de los nombres de columna. En este caso, podemos usar .str.replace(). Como ejemplo, añadamos la palabra "Original" delante de las columnas originales:
df.columns.str.replace("Col", "Original_column")Index(['Original_column0', 'Original_column1', 'Original_column2',
'Original_column3', 'Original_column4', 'Original_column5',
'Original_column6', 'New_column0', 'New_column1', 'New_column2',
'New_column3'],
dtype='object')Reordenar columnas
Por defecto, las nuevas columnas se añaden al lado derecho del dataframe. Pero puedes tener motivos para querer que las columnas aparezcan en un orden concreto, o quizá simplemente te resulte más cómodo tener las nuevas columnas a la izquierda cuando hay muchas columnas en un dataframe (lo cual pasa mucho).
La forma más sencilla de reordenar (todas) las columnas es crear una nueva lista con sus nombres en el orden que quieras: ¡pero ten cuidado de no olvidar ninguna columna que quieras conservar!
Veamos un ejemplo con una versión nueva de los datos ficticios de antes. Pondremos primero todas las columnas impares, en orden descendente, y luego las pares de la misma forma.
df = pd.DataFrame(
    data=np.reshape(range(36), (6, 6)),
    index=["a", "b", "c", "d", "e", "f"],
    columns=["col" + str(i) for i in range(6)],
    dtype=float,
)
df| col0 | col1 | col2 | col3 | col4 | col5 | |
|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 |
df = df[["col5", "col3", "col1", "col4", "col2", "col0"]]
df| col5 | col3 | col1 | col4 | col2 | col0 | |
|---|---|---|---|---|---|---|
| a | 5.0 | 3.0 | 1.0 | 4.0 | 2.0 | 0.0 |
| b | 11.0 | 9.0 | 7.0 | 10.0 | 8.0 | 6.0 |
| c | 17.0 | 15.0 | 13.0 | 16.0 | 14.0 | 12.0 |
| d | 23.0 | 21.0 | 19.0 | 22.0 | 20.0 | 18.0 |
| e | 29.0 | 27.0 | 25.0 | 28.0 | 26.0 | 24.0 |
| f | 35.0 | 33.0 | 31.0 | 34.0 | 32.0 | 30.0 |
¡Por supuesto, esto es bastante tedioso si tienes muchas columnas! Hay métodos que pueden facilitarlo según tu contexto. ¿Quizá solo quieras ordenar las columnas? Esto se consigue combinando sorted() y el comando reindex() (que funciona para filas o columnas) con axis=1, que indica el segundo eje (es decir, las columnas).
df.reindex(sorted(df.columns), axis=1)| col0 | col1 | col2 | col3 | col4 | col5 | |
|---|---|---|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 |
| b | 6.0 | 7.0 | 8.0 | 9.0 | 10.0 | 11.0 |
| c | 12.0 | 13.0 | 14.0 | 15.0 | 16.0 | 17.0 |
| d | 18.0 | 19.0 | 20.0 | 21.0 | 22.0 | 23.0 |
| e | 24.0 | 25.0 | 26.0 | 27.0 | 28.0 | 29.0 |
| f | 30.0 | 31.0 | 32.0 | 33.0 | 34.0 | 35.0 |
Repaso de cómo acceder a filas, columnas y valores
Con tantas formas distintas de acceder a valores en los dataframes, es fácil confundirse. Estas son las distintas formas de obtener la primera columna de un dataframe (cuando esa primera columna se llama column y el dataframe es df):
df.columndf["column"]df.loc[:, "column"]df.iloc[:, 0]
¡Ten en cuenta que : significa ‘dame todo’! Las formas de acceder a las filas son similares (suponiendo aquí que la primera fila se llama row):
df.loc["row", :]df.iloc[0, :]
Y para acceder al primer valor (es decir, el valor de la primera fila y la primera columna):
df.column[0]df["column"][0]df.iloc[0, 0]df.loc["row", "column"]
En los ejemplos anteriores, los corchetes son instrucciones sobre dónde tomar fragmentos del dataframe. Son algo así como un sistema de direcciones para los valores dentro de un dataframe. Sin embargo, los corchetes también denotan listas. Así que si quieres seleccionar varias columnas o filas, puede que veas una sintaxis como esta:
df.loc[["row0", "row1"], ["column0", "column2"]]
que selecciona dos filas y dos columnas mediante las listas ["row0", "row1"] y ["column0", "column2"]. Como hay listas junto al sistema habitual de selección de valores, aparecen dos pares de corchetes.
TipTip
Si solo quieres recordar una sintaxis para acceder a filas y columnas por nombre, usa el patrón df.loc[["row0", "row1", ...], ["col0", "col1", ...]]. También funciona con una sola fila o una sola columna (o ambas).
Si solo quieres recordar una sintaxis para acceder a filas y columnas por posición, usa el patrón df.iloc[[0, 1, ...], [0, 1, ...]]. También funciona con una sola fila o una sola columna (o ambas).
Ejercicios de columnas y filas
Compara
air_timeconarr_time - dep_time. ¿Qué esperas ver? ¿Qué ves? ¿Qué necesitas hacer para corregirlo?Compara
dep_time,sched_dep_timeydep_delay. ¿Cómo esperarías que se relacionen esos tres números?Piensa en tantas formas como sea posible de seleccionar
dep_time,dep_delay,arr_timeyarr_delaydeflights.¿Qué ocurre si incluyes el nombre de una fila o columna varias veces al intentar seleccionarlas?
¿Qué hace la función
.isin()en el siguiente código?flights.columns.isin(["year", "month", "day", "dep_delay", "arr_delay"])¿Te sorprende el resultado de ejecutar el siguiente código? ¿Cómo tratan por defecto las mayúsculas y minúsculas funciones como
str.contains? ¿Cómo puedes cambiar ese comportamiento por defecto?flights.loc[:, flights.columns.str.contains("TIME")](Pista: puedes usar la ayuda incluso con funciones que se aplican a dataframes, por ejemplo, usa
help(flights.columns.str.contains))
Agrupar, cambiar el índice y aplicar estadísticos de resumen
Hasta ahora has aprendido a trabajar con filas y columnas. pandas se vuelve aún más potente cuando añades la capacidad de trabajar con grupos. Crear grupos suele implicar también un cambio de índice. Y como los grupos tienden a implicar una agregación o combinación de datos, a menudo van de la mano de la aplicación de un estadístico de resumen.
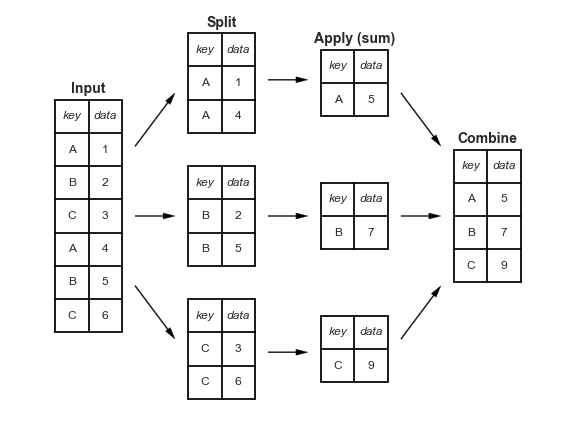
El siguiente diagrama da una idea de cómo estas operaciones pueden realizarse en conjunto. Observa que la operación de ‘dividir’ se logra mediante la agrupación, mientras que la de aplicar produce estadísticas de resumen. Al final, obtienes un dataframe con un nuevo índice (una entrada por grupo) en lo que se muestra como el paso de ‘combinar’.
Agrupar y agregar
Veamos cómo crear un grupo con la función .groupby(), seguida de la selección de una columna y la aplicación de una estadística de resumen mediante una agregación. Observa que la agregación, mediante .agg(), siempre produce un nuevo índice porque hemos condensado la información al nivel de grupo (y el nuevo índice está formado por esos niveles).
El punto clave que debes recordar es: usa .agg() con .groupby() cuando quieras que tus grupos se conviertan en el nuevo índice.
(flights.groupby("month")[["dep_delay"]].mean())| dep_delay | |
|---|---|
| month | |
| 1 | 10.036665 |
| 2 | 10.816843 |
| 3 | 13.227076 |
| 4 | 13.938038 |
| 5 | 12.986859 |
| 6 | 20.846332 |
| 7 | 21.727787 |
| 8 | 12.611040 |
| 9 | 6.722476 |
| 10 | 6.243988 |
| 11 | 5.435362 |
| 12 | 16.576688 |
Esto representa ahora el retraso medio de salida por mes. ¡Observa que nuestro índice ha cambiado! Ahora tenemos el mes donde originalmente teníamos un índice que era solo el número de fila. El índice desempeña un papel importante en las operaciones de agrupación porque lleva el registro de los grupos que tienes en el resto de tu dataframe.
A menudo querrás hacer varias operaciones de resumen de una sola vez. La sintaxis más completa para esto es mediante .agg(). Podemos reproducir lo que hicimos antes usando .agg():
(flights.groupby("month")[["dep_delay"]].agg("mean"))| dep_delay | |
|---|---|
| month | |
| 1 | 10.036665 |
| 2 | 10.816843 |
| 3 | 13.227076 |
| 4 | 13.938038 |
| 5 | 12.986859 |
| 6 | 20.846332 |
| 7 | 21.727787 |
| 8 | 12.611040 |
| 9 | 6.722476 |
| 10 | 6.243988 |
| 11 | 5.435362 |
| 12 | 16.576688 |
donde pasas la agregación que quieras. Algunas opciones comunes están en la siguiente tabla:
| Agregación | Descripción |
|---|---|
count() |
Número de elementos |
first(), last() |
Primer y último elemento |
mean(), median() |
Media y mediana |
min(), max() |
Mínimo y máximo |
std(), var() |
Desviación estándar y varianza |
mad() |
Desviación absoluta media |
prod() |
Producto de todos los elementos |
sum() |
Suma de todos los elementos |
value_counts() |
Conteo de valores únicos |
Para hacer varias agregaciones sobre varias columnas con nuevos nombres para las variables de salida, la sintaxis queda así
(
    flights.groupby(["month"]).agg(
        mean_delay=("dep_delay", "mean"),
        count_flights=("dep_delay", "count"),
    )
)| mean_delay | count_flights | |
|---|---|---|
| month | ||
| 1 | 10.036665 | 26483 |
| 2 | 10.816843 | 23690 |
| 3 | 13.227076 | 27973 |
| 4 | 13.938038 | 27662 |
| 5 | 12.986859 | 28233 |
| 6 | 20.846332 | 27234 |
| 7 | 21.727787 | 28485 |
| 8 | 12.611040 | 28841 |
| 9 | 6.722476 | 27122 |
| 10 | 6.243988 | 28653 |
| 11 | 5.435362 | 27035 |
| 12 | 16.576688 | 27110 |
¡Las medias y los conteos te pueden llevar sorprendentemente lejos en ciencia de datos!
Agrupar por varias variables
Esto es tan sencillo como pasarle a .groupby() una lista que represente varias columnas en lugar de un string que represente una sola columna.
month_year_delay = flights.groupby(["month", "year"]).agg(
    mean_delay=("dep_delay", "mean"),
    count_flights=("dep_delay", "count"),
)
month_year_delay| mean_delay | count_flights | ||
|---|---|---|---|
| month | year | ||
| 1 | 2013 | 10.036665 | 26483 |
| 2 | 2013 | 10.816843 | 23690 |
| 3 | 2013 | 13.227076 | 27973 |
| 4 | 2013 | 13.938038 | 27662 |
| 5 | 2013 | 12.986859 | 28233 |
| 6 | 2013 | 20.846332 | 27234 |
| 7 | 2013 | 21.727787 | 28485 |
| 8 | 2013 | 12.611040 | 28841 |
| 9 | 2013 | 6.722476 | 27122 |
| 10 | 2013 | 6.243988 | 28653 |
| 11 | 2013 | 5.435362 | 27035 |
| 12 | 2013 | 16.576688 | 27110 |
Quizá hayas notado que esta vez tenemos un multi-índice (es decir, un índice con más de una columna). Eso se debe a que pedimos algo con varios grupos, y el índice registra lo que ocurre dentro de cada grupo: por eso necesitamos más de una dimensión de índice para hacerlo de forma eficiente.
Si alguna vez quieres volver a un índice que sea solo la posición, prueba reset_index()
month_year_delay.reset_index()| month | year | mean_delay | count_flights | |
|---|---|---|---|---|
| 0 | 1 | 2013 | 10.036665 | 26483 |
| 1 | 2 | 2013 | 10.816843 | 23690 |
| 2 | 3 | 2013 | 13.227076 | 27973 |
| 3 | 4 | 2013 | 13.938038 | 27662 |
| 4 | 5 | 2013 | 12.986859 | 28233 |
| 5 | 6 | 2013 | 20.846332 | 27234 |
| 6 | 7 | 2013 | 21.727787 | 28485 |
| 7 | 8 | 2013 | 12.611040 | 28841 |
| 8 | 9 | 2013 | 6.722476 | 27122 |
| 9 | 10 | 2013 | 6.243988 | 28653 |
| 10 | 11 | 2013 | 5.435362 | 27035 |
| 11 | 12 | 2013 | 16.576688 | 27110 |
Aunque quizá solo quieras eliminar un nivel del índice. Esto se consigue pasando la posición del índice que quieres eliminar: por ejemplo, para convertir solo el índice del año en una columna, usaríamos:
month_year_delay.reset_index(1)| year | mean_delay | count_flights | |
|---|---|---|---|
| month | |||
| 1 | 2013 | 10.036665 | 26483 |
| 2 | 2013 | 10.816843 | 23690 |
| 3 | 2013 | 13.227076 | 27973 |
| 4 | 2013 | 13.938038 | 27662 |
| 5 | 2013 | 12.986859 | 28233 |
| 6 | 2013 | 20.846332 | 27234 |
| 7 | 2013 | 21.727787 | 28485 |
| 8 | 2013 | 12.611040 | 28841 |
| 9 | 2013 | 6.722476 | 27122 |
| 10 | 2013 | 6.243988 | 28653 |
| 11 | 2013 | 5.435362 | 27035 |
| 12 | 2013 | 16.576688 | 27110 |
Por último, puedes hacer reorganizaciones más complicadas del índice con una operación llamada unstack, que pivota la variable de índice elegida para que pase a ser una variable de columna (lo que introduce una estructura de columnas con varios niveles). Normalmente es mejor evitarlo.
Agrupar y transformar
Puede que no siempre quieras cambiar el índice para reflejar los nuevos grupos al realizar cálculos a nivel de grupo.
El punto clave que debes recordar es: usa .transform() con .groupby() cuando quieras realizar cálculos sobre tus grupos pero quieras volver al índice original.
Supongamos que queremos expresar el retraso de llegada, "arr_del", de cada vuelo como una fracción del peor retraso de llegada de cada mes.
flights["max_delay_month"] = flights.groupby("month")["arr_delay"].transform("max")
flights["delay_frac_of_max"] = flights["arr_delay"] / flights["max_delay_month"]
flights[
    ["year", "month", "day", "arr_delay", "max_delay_month", "delay_frac_of_max"]
].head()| year | month | day | arr_delay | max_delay_month | delay_frac_of_max | |
|---|---|---|---|---|---|---|
| 0 | 2013 | 1 | 1 | 11.0 | 1272.0 | 0.008648 |
| 1 | 2013 | 1 | 1 | 20.0 | 1272.0 | 0.015723 |
| 2 | 2013 | 1 | 1 | 33.0 | 1272.0 | 0.025943 |
| 3 | 2013 | 1 | 1 | -18.0 | 1272.0 | -0.014151 |
| 4 | 2013 | 1 | 1 | -25.0 | 1272.0 | -0.019654 |
Observa que las primeras entradas de "max_delay_month" son todas iguales porque el mes es el mismo para esas entradas, pero la fracción de retraso cambia en cada fila.
Ejercicios de groupby
¿Qué aerolínea tiene los peores retrasos? Desafío: ¿puedes separar los efectos de los malos aeropuertos frente a los de las malas aerolíneas? ¿Por qué sí o por qué no? (Pista: piensa en
flights.groupby(["carrier", "dest"]).count())Encuentra el vuelo con más retraso para cada destino.
¿Cómo varían los retrasos a lo largo del día?